Gemini 4 Argon fait parler de lui : après son annonce officielle du 30 septembre et son ouverture initiale aux acteurs de la cyberdéfense participant au programme Fairwind, Gemini 4 Argon est désormais disponible dans Vertex AI. Le déploiement à plus grande échelle a officiellement commencé du côté de Google Cloud. Pour la plupart des développeurs, la question la plus concrète est maintenant la suivante : comment se calcule le prix de Gemini 4 Argon et combien son utilisation coûtera-t-elle chaque mois ?
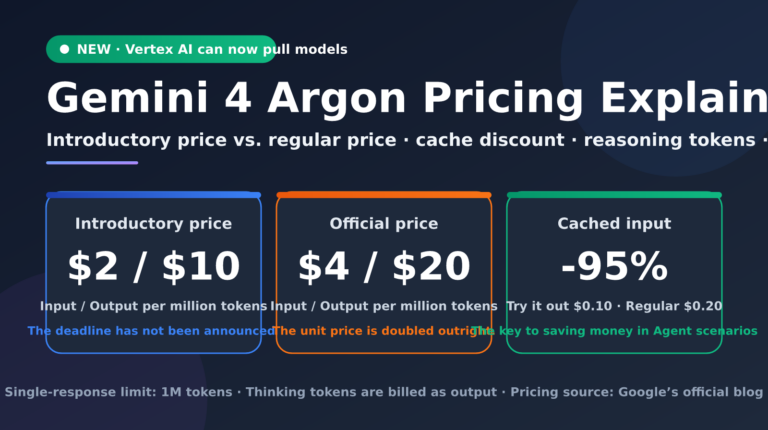
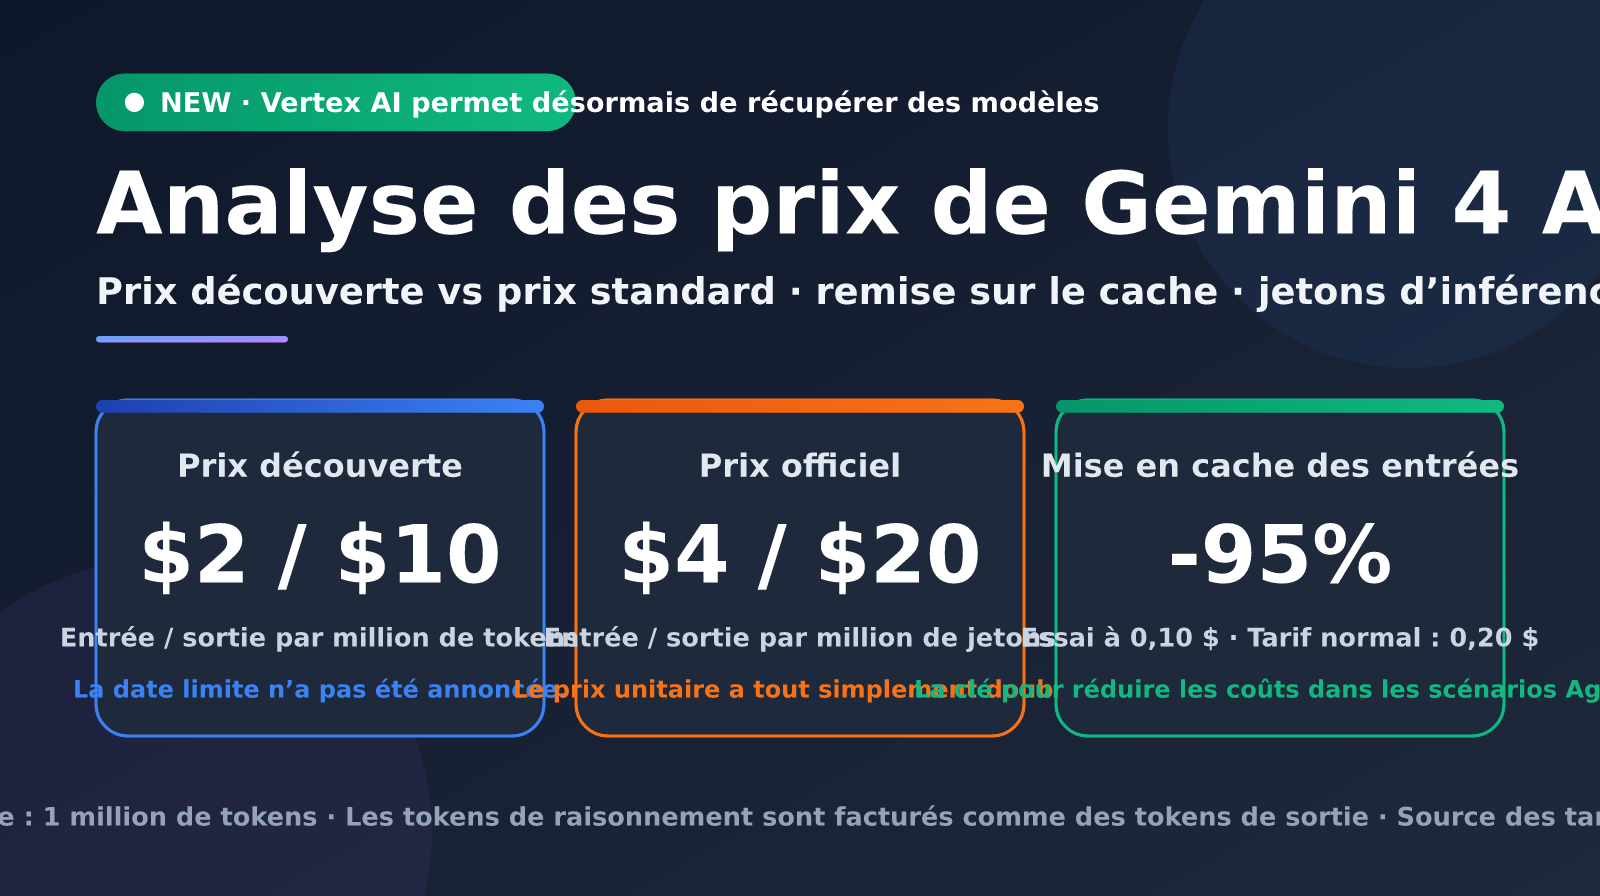
À première vue, la tarification d’Argon est simple : 2 $ en entrée et 10 $ en sortie par million de tokens pendant la période de lancement, puis 4 $/20 $ au tarif standard, avec une remise de 95 % sur les tokens d’entrée mis en cache. Mais cette grille tarifaire cache plusieurs variables : comment sont facturés les tokens de raisonnement ? La limite d’un million de tokens en sortie risque-t-elle de faire exploser le coût d’une seule requête ? Argon consomme-t-il beaucoup plus de tokens que ses concurrents ? À partir des articles officiels de Google, d’articles de plusieurs médias anglophones et de données publiées par des organismes d’évaluation tiers, cet article décortique le prix de Gemini 4 Argon et estime le coût de cinq scénarios courants.
Ce que vous allez apprendre : vous pourrez calculer le coût réel d’une tâche avec Gemini 4 Argon pour votre activité, anticiper l’évolution de la facture à la fin de la période de lancement et voir comment réduire les coûts grâce à la mise en cache et à la limitation de la sortie.
Tarifs de Gemini 4 Argon en un coup d’œil
Commençons par résumer les tarifs annoncés officiellement par Google. À noter : Google n’a publié que deux niveaux de prix, celui de la période de lancement et le tarif standard. La durée de la période de lancement n’a pas été précisée. Les tarifs Batch et Flex, les paliers pour les contextes longs et les frais de stockage du cache n’ont pas non plus été communiqués.
| Élément facturé | Tarif de lancement (par million de tokens) | Tarif standard (par million de tokens) | Remarques |
|---|---|---|---|
| Entrée | 2,00 $ | 4,00 $ | Durée de la période de lancement non précisée |
| Sortie | 10,00 $ | 20,00 $ | Google n’a pas précisé séparément la facturation des tokens de raisonnement |
| Entrée mise en cache | 0,10 $ | 0,20 $ | Remise de 95 % sur le tarif d’entrée ; tarif standard estimé avec la même remise |
| Limite de sortie par requête | 1 million de tokens | 1 million de tokens | Les modèles Gemini précédents étaient limités à 64 000 tokens |
| Batch / Flex | Non communiqué | Non communiqué | Les modèles Gemini existants proposent généralement des réductions pour le traitement par lots |
| Paliers pour les contextes longs | Non communiqué | Non communiqué | Google n’a pas non plus publié la taille de la fenêtre de contexte en entrée |
Trois détails importants sur les tarifs de Gemini 4 Argon
Premier détail : les tokens de raisonnement. Google n’a pas indiqué séparément comment sont facturés les tokens de réflexion d’Argon. Toutefois, dans la gamme Gemini actuelle, les tokens de réflexion sont généralement facturés au tarif de sortie. Pour établir un budget prudent, le plus sûr est de supposer qu’Argon suit la même règle : tous les tokens utilisés pendant le raisonnement sont donc facturés 10 $ (tarif de lancement) ou 20 $ (tarif standard) par million.
Deuxième détail : la remise sur le cache. Une remise de 95 % signifie que, pendant la période de lancement, l’entrée mise en cache ne coûte que 0,10 $ par million de tokens. Dans les flux de travail de type agent, chaque échange renvoie souvent le même invite système, les mêmes définitions d’outils et le même contexte de base de code. Le taux de réussite du cache peut alors dépasser 70 %, et cette remise peut avoir un effet plus important sur la facture totale que le tarif d’entrée de 2 $.
Troisième détail : la durée incertaine de la période de lancement. Une fois celle-ci terminée, tous les tarifs unitaires doublent, sans date de fin communiquée par Google. Si vos calculs de retour sur investissement reposent sur les tarifs de lancement, mieux vaut aussi préparer une estimation au tarif standard, pour éviter de découvrir un jour une facture qui a doublé.
🎯 Conseil budgétaire : Gemini 4 Argon comporte plusieurs variables tarifaires. Commencez par effectuer des tests à faible volume pour observer la répartition réelle de la consommation de tokens avant de décider d’une migration à grande échelle. La plateforme APIYI apiyi.com permet d’appeler Gemini, GPT, Claude et d’autres familles de modèles depuis une interface unifiée, ce qui facilite la comparaison des coûts réels sur un même ensemble de tâches.
Dernières actualités sur le lancement de Gemini 4 Argon dans Vertex AI
Le calendrier de disponibilité d’Argon est au cœur des préoccupations des développeurs. Selon le plan présenté dans l’article de blog de Google, Argon est d’abord destiné aux acteurs de la cyberdéfense de confiance participant au programme Fairwind et aux équipes internes de Google. Il sera ensuite proposé aux clients API payants et aux abonnés Google AI Ultra, avant d’être mis à la disposition d’un public plus large de développeurs, d’entreprises et de particuliers. Le tableau ci-dessous retrace les principales étapes, de l’annonce officielle à la disponibilité du modèle dans Vertex AI.
| Date | Événement | Source |
|---|---|---|
| 3 septembre | Lancement du programme Fairwind, avec Gemini 3.8 Flash Cyber comme premier modèle | Blog officiel de Google |
| 30 septembre | Annonce de Gemini 4 Argon et déploiement auprès des membres de Fairwind | Blog officiel de Google |
| 30 septembre | Vérification par DataCamp : le modèle n’est disponible ni dans Vertex AI, ni dans Gemini CLI, entre autres | DataCamp |
| 7-8 octobre | La communauté repère l’entrée gemini-4-argon-cyber-permissive dans Vertex AI |
Communauté et médias technologiques |
| Mi-octobre | Le modèle Gemini 4 Argon peut désormais être sélectionné dans Vertex AI | Dernières actualités |
L’identifiant gemini-4-argon-cyber-permissive, repéré en premier par la communauté, est intéressant. « Cyber-permissive » laisse entendre qu’il s’agit d’une version destinée aux acteurs de la cyberdéfense, avec des garde-fous de cybersécurité assouplis. Cela correspond à la description de Google, qui indique que les défenseurs de confiance ne sont pas soumis à ces garde-fous. La version destinée aux clients payants classiques devrait probablement avoir un identifiant différent et conserver l’ensemble des protections de sécurité. Pour l’intégration, référez-vous à l’identifiant du modèle affiché dans le Model Garden de votre propre console Google Cloud, plutôt que de reprendre sans vérification les noms qui circulent en ligne.
Prix de Gemini 4 Argon dans Vertex AI et évolution de la plateforme
Selon des informations partagées par la communauté, le prix mondial d’Argon affiché dans Vertex AI est de 4 $ par million de tokens en entrée et de 20 $ par million de tokens en sortie, soit le tarif standard indiqué dans l’article de blog de Google. C’est un point à prendre au sérieux : si l’utilisation de Vertex AI est facturée directement au tarif standard, les estimations calculées à partir des tarifs de lancement à 2 $/10 $ doivent être doublées. Google n’a pas encore précisé les canaux concernés par ces tarifs de lancement. Avant l’intégration, vérifiez donc le prix unitaire réel sur la page de facturation de la console.
Autre changement facile à manquer : la plateforme elle-même évolue. Lors de la conférence Cloud Next d’avril 2026, Google a intégré les services Vertex AI à Gemini Enterprise Agent Platform. La documentation de l’ancienne version de Vertex AI indique désormais qu’elle ne sera plus mise à jour. Les points de terminaison existants restent disponibles, mais la documentation et les nouvelles fonctionnalités des modèles récents comme Argon seront d’abord publiées dans Agent Platform. Par ailleurs, Gemini 2.5 Pro, 2.5 Flash et 2.5 Flash-Lite seront retirés le 16 octobre. Les équipes qui utilisent encore ces modèles peuvent profiter de cette occasion pour mener leur migration en une seule fois.
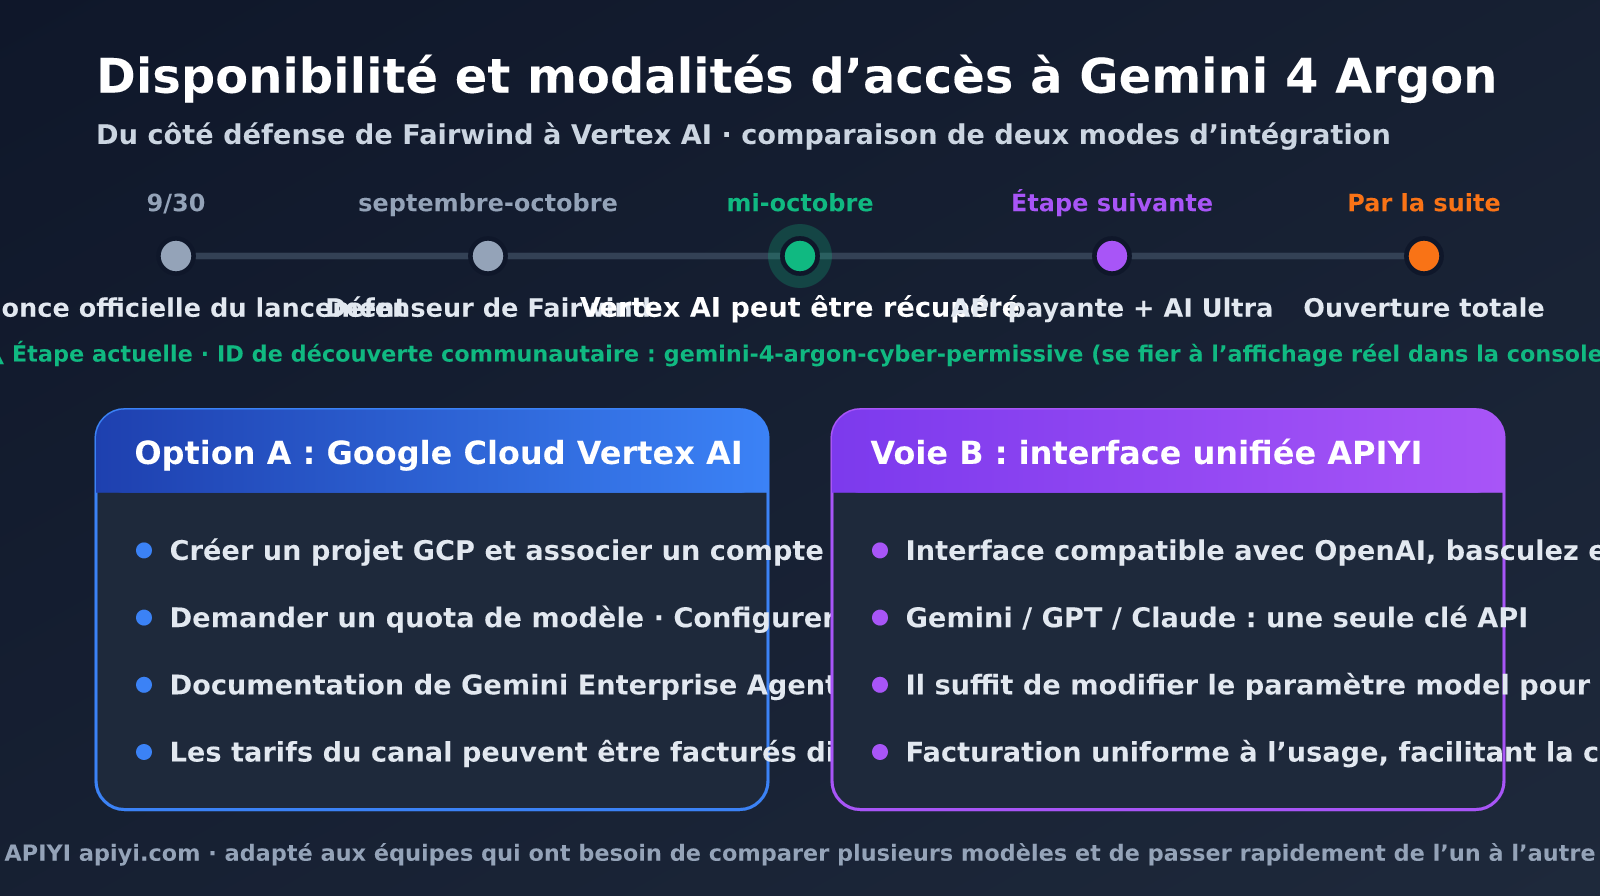
🚀 Conseil d’intégration : l’accès direct à Vertex AI nécessite un projet GCP, un compte de facturation, une demande de quota et une configuration IAM. La démarche peut être assez lourde pour les petites et moyennes équipes. Nous vous conseillons de passer par l’interface compatible avec OpenAI de la plateforme APIYI apiyi.com pour accéder à l’ensemble des modèles Gemini. Il suffit de modifier le paramètre
modelpour passer d’Argon à un autre modèle.
Comparaison des prix de Gemini 4 Argon : les modèles de la même famille et la concurrence
Le prix unitaire ne suffit pas pour savoir si Argon est cher. Il faut le comparer à Gemini 3.8 Flash, un modèle de la même famille, ainsi qu’aux modèles phares concurrents. Le tableau ci-dessous présente les tarifs affichés. Les prix des concurrents proviennent de compilations tierces ; consultez les pages officielles des fournisseurs pour connaître les tarifs en vigueur.
| Modèle | Entrée / million de tokens | Sortie / million de tokens | Limite de sortie par requête | Positionnement |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | — | Modèle polyvalent au quotidien, excellent rapport qualité-prix |
| Gemini 4 Argon (tarif de lancement) | $2.00 | $10.00 | 1M | Modèle phare pour le raisonnement en plusieurs étapes |
| Gemini 4 Argon (tarif standard) | $4.00 | $20.00 | 1M | Modèle phare pour le raisonnement en plusieurs étapes |
| Claude Opus 5.5 | $4.00 | $20.00 | 128K | Modèle phare concurrent |
| GPT-6 Astra | $10.00 | $50.00 | 128K | Modèle phare concurrent |
Au tarif de lancement, Argon coûte environ 2,7 fois plus cher que Gemini 3.8 Flash. Son tarif standard est aligné sur celui de Claude Opus 5.5 et représente seulement 40 % de celui de GPT-6 Astra. Mais le prix unitaire ne fait qu’une partie du calcul : l’autre consiste à savoir combien de tokens sont nécessaires pour accomplir une même tâche. C’est le principal point de vigilance concernant le tarif d’Argon.
Coût de Gemini 4 Argon par tâche : la consommation de tokens est déterminante
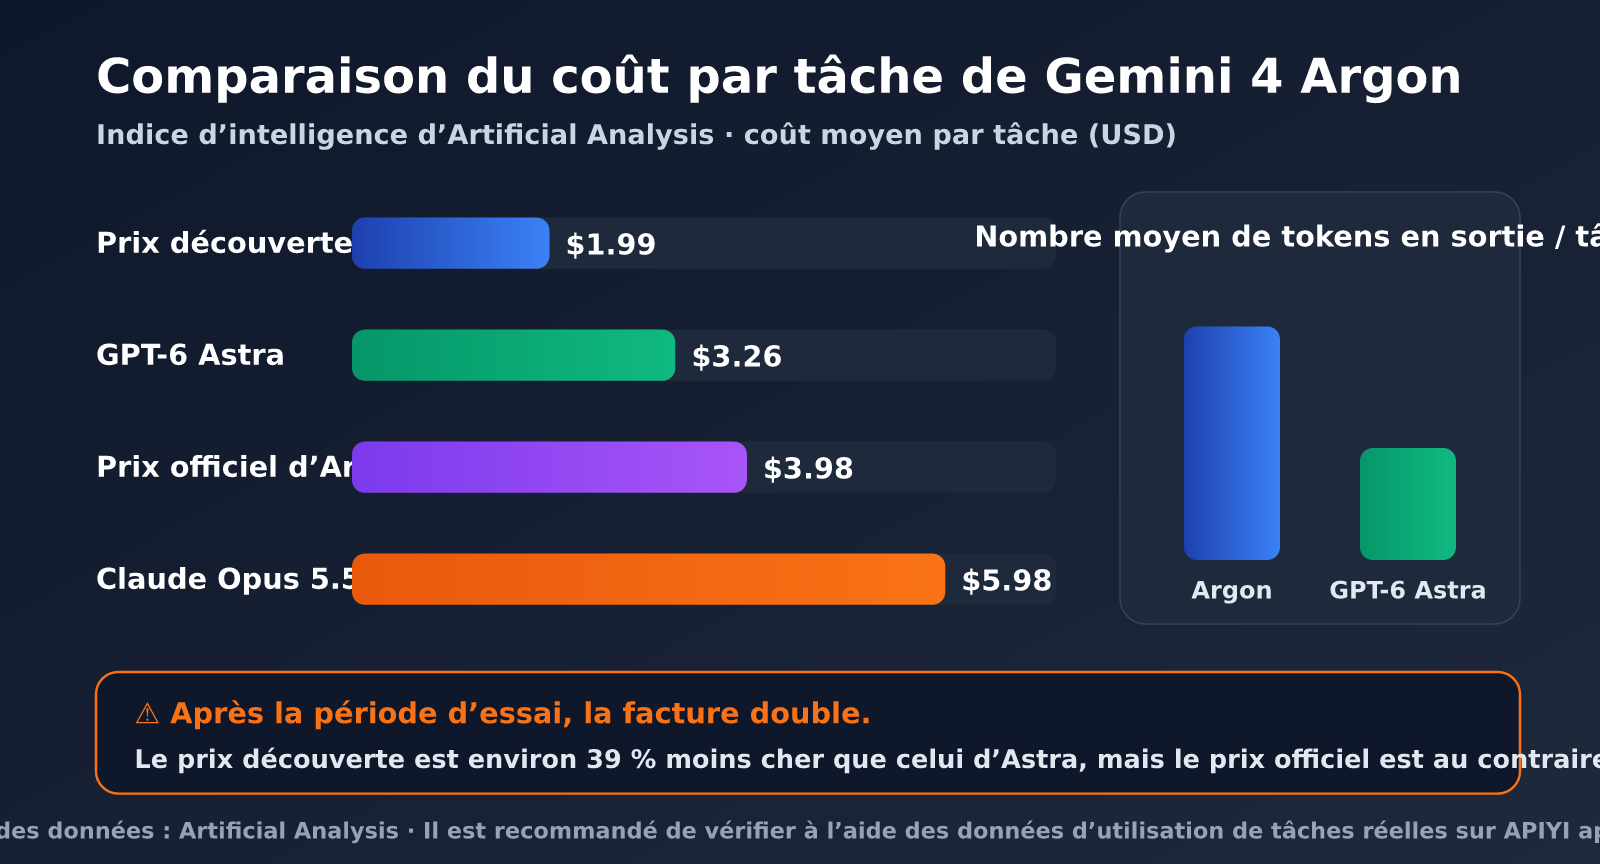
Le coût par tâche, calculé par des organismes d’évaluation tiers, est plus révélateur que le prix unitaire. Selon les données d’Artificial Analysis, Argon génère en moyenne environ 62 000 tokens de sortie par tâche lors du test Intelligence Index. GPT-6 Astra, qui obtient un score équivalent, n’en génère qu’environ 27 000 : Argon produit donc plus de deux fois plus de « texte ».
| Méthode d’évaluation | Gemini 4 Argon | Modèle de comparaison | Conclusion |
|---|---|---|---|
| Coût par tâche AA (tarif de lancement) | $1.99 | GPT-6 Astra : $3.26 | Pendant la période de lancement, Argon coûte environ 39 % moins cher qu’Astra |
| Coût par tâche AA (tarif standard) | $3.98 | GPT-6 Astra : $3.26 | Au tarif standard, Argon coûte au contraire environ 22 % plus cher qu’Astra |
| Coût par tâche AA | $1.99 | Claude Opus 5.5 : $5.98 | Environ un tiers du coût d’Opus 5.5 |
| Coût par test Vals | $15.68 | Opus 5.5 : $32.14 / Sonnet 5.5 : $21.34 | Coût le plus bas pour cette charge de travail |
| Nombre moyen de tokens de sortie par tâche | Environ 62 000 | GPT-6 Astra : environ 27 000 | Le raisonnement d’Argon est nettement plus long |
Ce tableau met en évidence le point le plus important concernant le prix de Gemini 4 Argon : pendant la période de lancement, Argon offre un très bon rapport qualité-prix, mais après cette période, il peut coûter plus cher que GPT-6 Astra, dont le prix unitaire est pourtant plus élevé, pour certaines charges de travail. La raison tient à sa consommation de tokens de sortie. Toutefois, les tests de Vals montrent aussi qu’Argon est le moins cher pour un autre type de charge de travail. La conclusion dépend donc fortement de la tâche : il faut faire ses propres calculs à partir de ses données.
💡 Conseil pour choisir un modèle : un prix unitaire bas ne garantit pas une facture moins élevée. Sur la plateforme APIYI apiyi.com, faites traiter le même ensemble de tâches réelles par Argon et d’autres modèles phares, puis consignez le champ
usagede chaque requête. Fondez votre stratégie de routage sur la consommation réelle de tokens plutôt que sur les tarifs affichés.
Estimation du coût réel de Gemini 4 Argon : 5 cas d’usage typiques
À partir des tarifs publiés par Google, estimons le coût d’une requête pour cinq cas d’usage typiques, au tarif de lancement et au tarif standard. Les tokens de raisonnement sont comptabilisés avec les tokens de sortie.
| Scénario | Tokens d’entrée | Tokens de sortie | Coût au tarif de lancement | Coût au tarif standard |
|---|---|---|---|---|
| Questions-réponses au quotidien | 20 000 | 5 000 | $0.09 | $0.18 |
| Analyse de longs documents | 200 000 | 50 000 | $0.90 | $1.80 |
| Programmation avec un agent (80 % de cache) | 600 000 | 62 000 | $0.91 | $1.82 |
| Migration de grande ampleur du code | 300 000 | 400 000 | $4.60 | $9.20 |
| Sortie maximale de 1M | Négligeable | 1 million | $10.00 | $20.00 |
Prenons le cas de la programmation avec un agent : sur les 600 000 tokens d’entrée, 480 000 sont trouvés dans le cache et facturés au tarif de $0.10, soit seulement $0.048. Les 120 000 restants sont facturés à $2, soit $0.24. Enfin, les 62 000 tokens de sortie sont facturés à $10, soit $0.62. Le total s’élève à environ $0.91. Avec un cache bien exploité, les tokens de sortie représentent près de 70 % du coût total : réduire la longueur des réponses est plus important que de réduire les tokens d’entrée.
La migration de grande ampleur du code et la sortie maximale de 1M sont les deux scénarios qui demandent le plus de vigilance. La limite de sortie de 1M est l’un des principaux atouts d’Argon, mais une sortie maximale coûte $20 au tarif standard. Si les paramètres de délai d’expiration du client ne sont pas adaptés et qu’une requête échoue avant d’être relancée automatiquement, le coût peut directement doubler. Pour les équipes qui exécutent des centaines de longues tâches par jour, ces coûts cachés peuvent rapidement faire déraper la facture mensuelle.
Liste des coûts cachés de Gemini 4 Argon
À la lumière de ces estimations, voici les principaux coûts cachés à surveiller lors de l’intégration d’Argon :
- Explosion du nombre de tokens de raisonnement : Argon génère en moyenne plus de deux fois plus de tokens de sortie que GPT-6 Astra. Les tokens du processus de réflexion, facturés au tarif de sortie, peuvent donc alourdir sensiblement le coût par tâche.
- Sorties très longues et nouvelles tentatives : avec une limite de sortie de 1M, des délais d’expiration mal réglés côté client ou au niveau de l’équilibreur de charge peuvent faire échouer les longues requêtes et déclencher de nouvelles tentatives, multipliant les coûts.
- Échec du cache : une structure d’invite mal conçue peut entraîner un taux d’utilisation du cache très faible et faire perdre la réduction de 95 %.
- Fin de la période de lancement : tous les tarifs unitaires doublent, sans date de fin clairement annoncée.
- Différences de prix selon le canal : le prix affiché sur Vertex AI peut correspondre directement au tarif standard, soit deux fois le montant estimé avec le tarif de lancement.
Pratique : réduire les coûts avec Gemini 4 Argon
Pour maîtriser les coûts cachés évoqués plus haut, trois mesures sont particulièrement efficaces : définir une limite de sortie claire pour chaque requête, placer les éléments stables au début de l’invite pour améliorer le taux d’accès au cache et router les tâches en fonction de leur difficulté. L’exemple ci-dessous utilise une interface compatible avec OpenAI ; l’ID du modèle est configuré à l’aide d’une variable d’environnement.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# 模型 ID 以平台或 Vertex AI 控制台实际显示为准
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")

resp = client.chat.completions.create(
    model=ARGON,
    max_tokens=16000,  # 显式设置输出上限,避免默认放开到 1M
    messages=[{"role": "user", "content": "分析这段代码的并发安全问题"}],
)
u = resp.usage
print(f"输入 {u.prompt_tokens} / 输出 {u.completion_tokens} token")
Voir le code complet : routage selon la difficulté et suivi des coûts
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

# 模型与单价全部配置化,尝鲜期结束后只需改环境变量
ROUTES = {
    "easy": {
        "model": os.getenv("FLASH_MODEL", "gemini-3.8-flash"),
        "price_in": 0.75, "price_out": 3.75, "max_tokens": 8000,
    },
    "hard": {
        "model": os.getenv("ARGON_MODEL", "gemini-4-argon"),
        "price_in": float(os.getenv("ARGON_PRICE_IN", "2")),
        "price_out": float(os.getenv("ARGON_PRICE_OUT", "10")),
        "max_tokens": 64000,
    },
}

# 稳定前缀放在最前面,提升缓存命中率
SYSTEM_PREFIX = open("system_prompt.md", encoding="utf-8").read()


def classify(task: str) -> str:
    """简单示例:长任务、迁移、审计类任务走 Argon,其余走 Flash"""
    keywords = ("迁移", "重构", "审计", "漏洞", "多文件")
    return "hard" if len(task) > 4000 or any(k in task for k in keywords) else "easy"


def run(task: str) -> str:
    route = ROUTES[classify(task)]
    resp = client.chat.completions.create(
        model=route["model"],
        max_tokens=route["max_tokens"],
        messages=[
            {"role": "system", "content": SYSTEM_PREFIX},
            {"role": "user", "content": task},
        ],
        timeout=600,  # 长输出任务放宽超时,避免失败重试导致成本翻倍
    )
    u = resp.usage
    cost = (u.prompt_tokens * route["price_in"]
            + u.completion_tokens * route["price_out"]) / 1_000_000
    print(f"[{route['model']}] in={u.prompt_tokens} out={u.completion_tokens} "
          f"估算成本 ${cost:.4f}(未计缓存折扣)")
    return resp.choices[0].message.content


if __name__ == "__main__":
    print(run("把 legacy/ 目录下的 C 模块迁移为 Rust,并保持接口一致"))
Ce code met en pratique trois principes pour réduire les coûts. Premièrement, définissez explicitement max_tokens au lieu de vous fier à la limite de sortie très élevée par défaut du modèle. Deuxièmement, placez l’invite système comme préfixe stable au début de la requête afin d’augmenter les chances que les requêtes successives bénéficient du cache. Enfin, routez les tâches selon leur difficulté : confiez les tâches simples à Gemini 3.8 Flash, dont le tarif représente environ un tiers de celui d’Argon, et réservez Argon aux tâches complexes et aux chaînes de traitement longues.
Conseil : vous pouvez commencer par obtenir un crédit d’essai sur APIYI, apiyi.com, puis exécuter le script de routage ci-dessus pendant une semaine sur du trafic réel. Ajustez ensuite les seuils de routage et les limites de sortie en fonction des journaux d’utilisation.
Questions fréquentes
Q1 : Quel est le tarif actuel de Gemini 4 Argon : 2 $/10 $ ou 4 $/20 $ ?
Le tarif d’accès anticipé annoncé par Google est de 2 $/10 $, contre 4 $/20 $ au tarif normal. Google n’a toutefois précisé ni la durée de cette période d’accès anticipé, ni si tous les canaux appliquent les mêmes tarifs. Selon des informations de la communauté, Vertex AI affiche le tarif normal de 4 $/20 $. Fiez-vous au tarif indiqué sur la facture de votre canal d’accès et prévoyez votre budget en tenant compte des deux grilles tarifaires.
Q2 : Peut-on utiliser directement `gemini-4-argon-cyber-permissive` sur Vertex AI ?
D’après son nom, cet ID correspond à une version destinée aux équipes de défense en cybersécurité, avec des garde-fous assouplis dans ce domaine. Elle est associée aux droits d’accès du programme Fairwind ; les projets ordinaires n’y ont généralement pas accès. Si vous êtes un client payant standard, utilisez l’ID du modèle affiché dans Model Garden sur votre propre console. Si vous préférez éviter la configuration des projets GCP, des quotas et des autorisations, vous pouvez aussi appeler les modèles Gemini depuis une plateforme d’agrégation comme APIYI, apiyi.com.
Q3 : Les tokens de raisonnement d’Argon sont-ils facturés en supplément ?
Google ne l’a pas encore précisé séparément. Cependant, les tokens de raisonnement des modèles Gemini actuels sont facturés au tarif des tokens de sortie ; mieux vaut donc prévoir le budget selon la même règle. Argon générant en moyenne davantage de tokens, ceux consacrés au raisonnement peuvent représenter une part importante du coût. Vous pouvez maîtriser celui-ci en limitant `max_tokens` et en ajustant l’intensité du raisonnement.
Q4 : Dans quels cas vaut-il la peine de payer pour Gemini 4 Argon ?
Argon se distingue surtout dans les tâches longues, comme les migrations de code à grande échelle, l’analyse spécialisée de documents volumineux, les agents juridiques ou financiers et les audits de sécurité. Ces usages peuvent justifier son tarif. Pour les questions courantes, la complétion de code simple et les tâches légères à fort volume, un modèle moins cher comme Gemini 3.8 Flash est généralement plus avantageux. Pour choisir la bonne proportion de routage, le plus sûr est de comparer les résultats sur des tâches réelles avec la plateforme APIYI, apiyi.com.
Résumé
Le prix de Gemini 4 Argon peut se résumer ainsi : « un tarif affiché attractif, mais de nombreuses variables ». À 2 $/10 $ pendant la période de lancement, il est très compétitif parmi les modèles haut de gamme. La remise de 95 % sur les tokens mis en cache est particulièrement intéressante pour les agents. Mais la consommation élevée de tokens de raisonnement, le doublement du tarif unitaire à la fin de la période de lancement et l’application possible du tarif standard via Vertex AI peuvent créer un écart important entre la facture réelle et les attentes fondées sur le prix affiché.
Maintenant que Gemini 4 Argon est disponible sur Vertex AI, l’enjeu n’est pas de tout migrer immédiatement, mais de mesurer d’abord la répartition de la consommation de tokens sur du trafic réel, puis de maîtriser les coûts en limitant la longueur des réponses, en mettant en cache les préfixes et en orientant les requêtes selon leur niveau de difficulté. Nous recommandons de réserver Argon aux « problèmes difficiles » et de l’associer à des modèles de la gamme Flash.
Nous recommandons de passer par la plateforme APIYI apiyi.com pour accéder à l’ensemble de la gamme Gemini depuis une interface unique et comparer les coûts et les performances d’Argon avec ceux d’autres modèles. Mieux vaut s’appuyer sur les données que sur les prix affichés pour définir sa stratégie de sélection des modèles.
Références :
- Article officiel de Google sur le lancement de Gemini 4 Argon : blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Présentation du programme Fairwind de Google : deepmind.google/fairwind-program
- Synthèse de DataCamp sur les benchmarks et les tarifs de Gemini 4 Argon : datacamp.com/blog/gemini-4-argon
- Coûts des modèles et indice d’intelligence d’Artificial Analysis : artificialanalysis.ai
- Évaluations et données de coût des modèles par Vals AI : vals.ai
Auteur : APIYI Team | Nous suivons de près l’évolution des prix et des solutions d’accès aux grands modèles de langage. Pour en savoir plus sur l’accès aux modèles d’IA, rendez-vous sur APIYI apiyi.com.