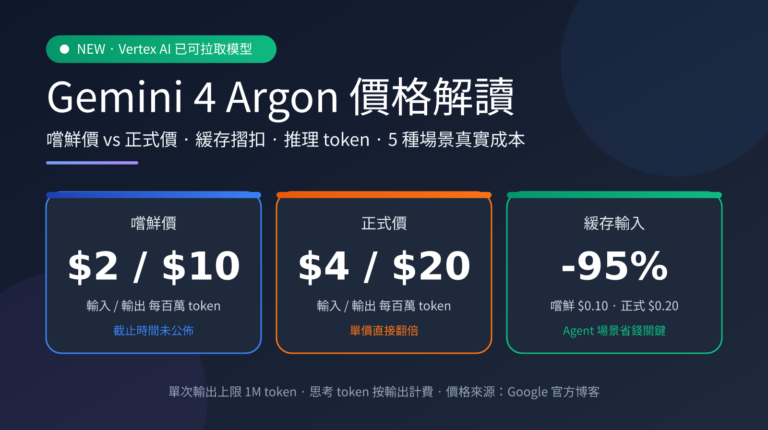
Gemini 4 Argon macht Fortschritte: Nach der offiziellen Ankündigung am 30. September und der zunächst auf Netzwerkverteidiger im Fairwind-Programm beschränkten Verfügbarkeit lässt sich Gemini 4 Argon jetzt als Modell in Vertex AI abrufen. Damit beginnt die schrittweise Bereitstellung auf Google Cloud. Für die meisten Entwickler stellt sich nun vor allem eine praktische Frage: Wie genau wird Gemini 4 Argon abgerechnet, und wie viel kostet der Einsatz pro Monat?
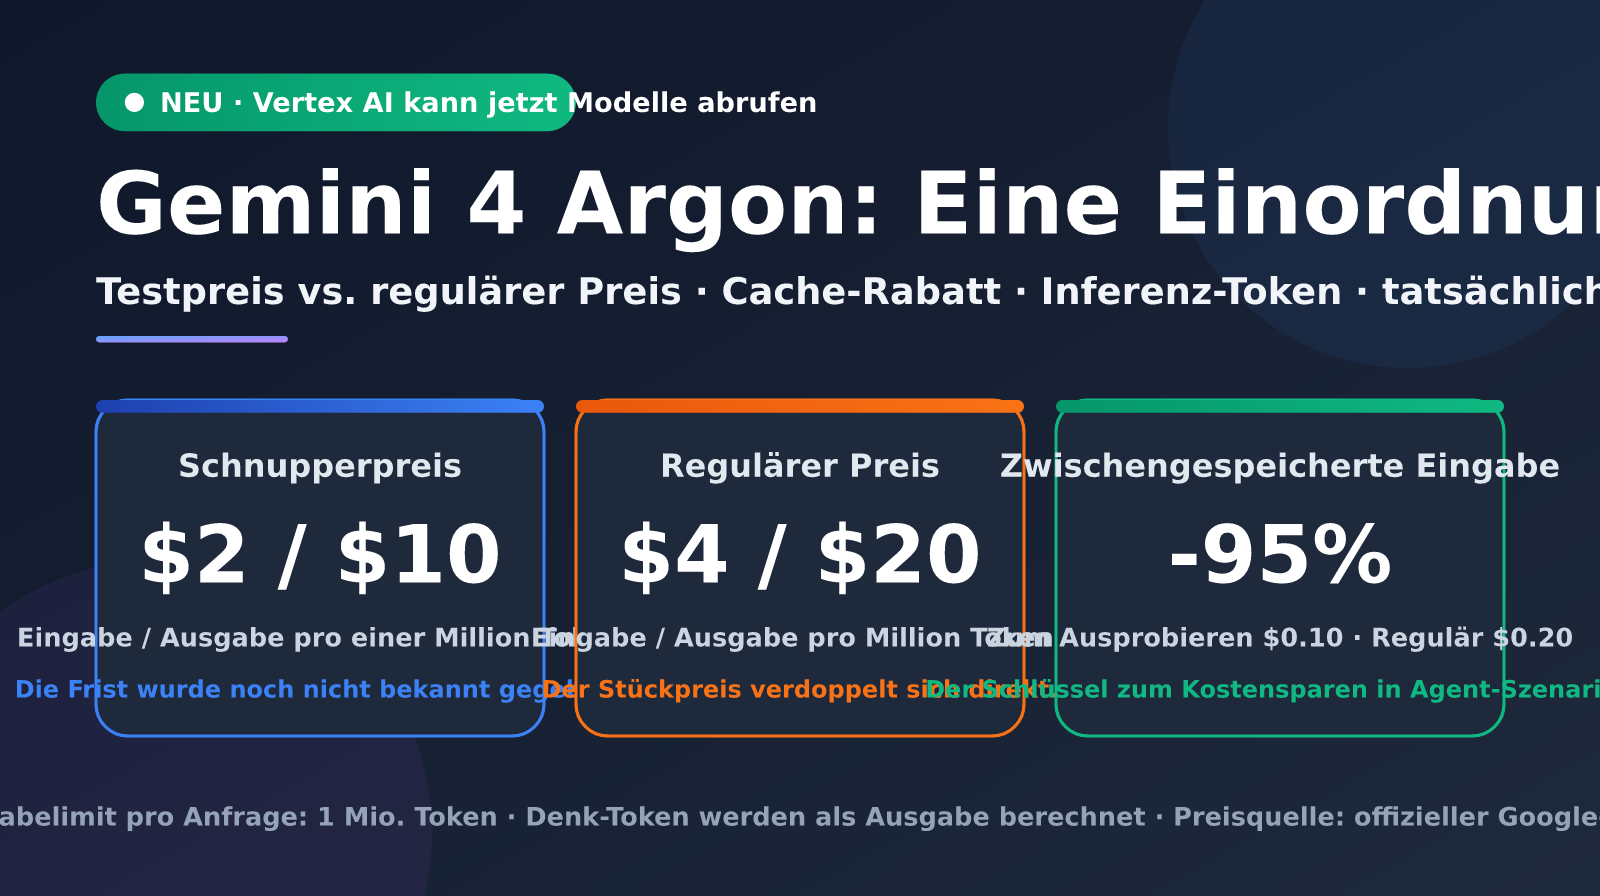
Auf den ersten Blick ist die Preisgestaltung von Argon einfach: In der Vorabphase kostet die Eingabe 2 $ und die Ausgabe 10 $ pro Million Token. Der reguläre Preis verdoppelt sich auf 4 beziehungsweise 20 $. Für gecachte Eingaben gibt es 95 % Rabatt. Hinter dieser Preisliste verbergen sich jedoch einige Variablen: Wie werden Reasoning-Token abgerechnet? Könnte das Ausgabelimit von 1 Mio. Token die Kosten einzelner Anfragen aus dem Ruder laufen lassen? Und wie viel mehr Token verbraucht Argon im Vergleich zu Konkurrenzmodellen? In diesem Artikel schlüsseln wir die Preise von Gemini 4 Argon anhand offizieller Google-Beiträge sowie öffentlich verfügbarer Daten aus englischsprachigen Medien und von unabhängigen Testinstituten auf. Außerdem berechnen wir die Kosten für fünf typische Szenarien.
Das Wichtigste: Nach der Lektüre können Sie die tatsächlichen Kosten einer einzelnen Aufgabe mit Gemini 4 Argon für Ihren Anwendungsfall berechnen. Sie wissen, wie sich die Rechnung nach Ende der Vorabphase verändert und wie sich die Kosten mithilfe von Caching und Ausgabelimits senken lassen.
Preise von Gemini 4 Argon im Überblick
Zunächst haben wir die von Google offiziell veröffentlichten Preise in einer Tabelle zusammengefasst. Wichtig: Google nennt lediglich zwei Preisstufen – für die Vorabphase und den regulären Betrieb. Wie lange die Vorabphase dauert, ist nicht bekannt. Auch zu Batch, Flex, Preisstaffelungen für lange Kontexte und Gebühren für die Speicherung von Caches gibt es keine Angaben.
| Abrechnungsposten | Preis in der Vorabphase (pro Million Token) | Regulärer Preis (pro Million Token) | Hinweis |
|---|---|---|---|
| Eingabe | 2,00 $ | 4,00 $ | Dauer der Vorabphase nicht bekannt |
| Ausgabe | 10,00 $ | 20,00 $ | Google hat nicht gesondert erläutert, wie Reasoning-Token abgerechnet werden |
| Gecachte Eingaben | 0,10 $ | 0,20 $ | 95 % Rabatt auf den Eingabepreis; der reguläre Preis wurde anhand desselben Rabatts berechnet |
| Ausgabelimit pro Anfrage | 1 Mio. Token | 1 Mio. Token | Bei früheren Gemini-Modellen waren es 64.000 Token |
| Batch / Flex | Nicht bekannt | Nicht bekannt | Für bestehende Gemini-Modelle gibt es üblicherweise Batch-Rabatte |
| Preisstaffelung für lange Kontexte | Nicht bekannt | Nicht bekannt | Auch die Größe des Eingabekontextfensters wurde von Google nicht bekannt gegeben |
Drei wichtige Details zur Preisgestaltung von Gemini 4 Argon
Das erste Detail betrifft Reasoning-Token. Google hat nicht gesondert erläutert, wie Argons Denk-Token abgerechnet werden. Bei den aktuellen Gemini-Modellen werden Denk-Token üblicherweise zum Ausgabepreis berechnet. Für eine möglichst sichere Budgetplanung sollten Sie davon ausgehen, dass Argon dieselbe Regel nutzt. Das bedeutet: Alle Denkprozesse werden mit 10 $ (Vorabphase) beziehungsweise 20 $ (regulärer Preis) pro Million Token berechnet.
Das zweite Detail betrifft den Cache-Rabatt. Ein Rabatt von 95 % bedeutet, dass gecachte Eingaben während der Vorabphase nur 0,10 $ pro Million Token kosten. In agentenbasierten Workflows werden System-Eingabeaufforderungen, Tooldefinitionen und Codekontext bei jeder Gesprächsrunde erneut übertragen. Die Cache-Trefferquote kann dabei oft über 70 % liegen. Dieser Rabatt kann sich stärker auf die Gesamtrechnung auswirken als der Listenpreis von 2 $.
Das dritte Detail ist die ungewisse Dauer der Vorabphase. Nach ihrem Ende verdoppeln sich alle Einzelpreise. Google hat jedoch kein Enddatum genannt. Wenn Sie Ihre ROI-Berechnung auf Grundlage der Vorabpreise erstellen, sollten Sie daher auch eine Variante mit den regulären Preisen kalkulieren. So vermeiden Sie Überraschungen, falls sich Ihre Rechnung eines Tages plötzlich verdoppelt.
🎯 Budgettipp: Bei Gemini 4 Argon gibt es viele Variablen. Testen Sie das Modell zunächst mit geringem Datenvolumen, um die tatsächliche Verteilung des Token-Verbrauchs zu ermitteln, und entscheiden Sie erst danach über einen umfassenden Umstieg. Über die einheitliche Schnittstelle der Plattform APIYI apiyi.com können Sie Gemini, GPT, Claude und weitere Modellfamilien parallel aufrufen und die tatsächlichen Kosten für dieselben Aufgaben vergleichen.
Aktuelle Entwicklungen zum Start von Gemini 4 Argon auf Vertex AI
Der Zeitplan für die Freigabe von Argon ist für Entwickler besonders wichtig. Laut Googles Blogbeitrag wird das Modell zunächst vertrauenswürdigen Netzwerkverteidigern im Fairwind-Programm und intern bei Google zur Verfügung gestellt. Danach folgen zahlende API-Kunden und Abonnenten von Google AI Ultra. Erst anschließend soll Argon für eine breitere Gruppe von Entwicklern, Unternehmen und Privatkunden verfügbar sein. Die folgende Tabelle fasst den Zeitraum von der Ankündigung bis zur Abrufbarkeit auf Vertex AI zusammen.
| Zeitpunkt | Ereignis | Informationsquelle |
|---|---|---|
| 3. September | Start des Fairwind-Programms mit Gemini 3.8 Flash Cyber als erstem Modell | Offizieller Google-Blog |
| 30. September | Ankündigung von Gemini 4 Argon und Bereitstellung für Fairwind-Mitglieder | Offizieller Google-Blog |
| 30. September | Prüfung durch DataCamp: Auf Vertex AI, in der Gemini CLI und anderen Angeboten noch nicht verfügbar | DataCamp |
| 7.–8. Oktober | Community entdeckt den Eintrag gemini-4-argon-cyber-permissive auf Vertex AI |
Community und Tech-Medien |
| Mitte Oktober | Gemini 4 Argon kann auf Vertex AI abgerufen werden | Aktuelle Entwicklungen |
Die zuerst von der Community entdeckte Modell-ID gemini-4-argon-cyber-permissive ist aufschlussreich. „Cyber-permissive“ deutet auf eine Version für Netzwerkverteidiger hin, bei der die Cybersicherheitsleitplanken gelockert sind. Das deckt sich mit der Beschreibung im Google-Blog, wonach für vertrauenswürdige Verteidiger keine Cybersicherheitsleitplanken gelten. Die Version für reguläre zahlende Kunden dürfte eine andere ID verwenden und den vollständigen Sicherheitsschutz beibehalten. Maßgeblich ist daher beim Einrichten die Modell-ID, die in Ihrem Google-Cloud-Projekt unter Model Garden tatsächlich angezeigt wird. Übernehmen Sie nicht einfach einen Namen, der im Internet kursiert.
Preise und Plattformänderungen für Gemini 4 Argon auf Vertex AI
Laut Community-Angaben wird Argon auf Vertex AI weltweit mit 4 $ pro Million Eingabe-Token und 20 $ pro Million Ausgabe-Token ausgewiesen – also zum regulären Preis aus Googles Blogbeitrag. Das ist wichtig: Wenn Unternehmen Vertex AI nutzen und direkt zum regulären Preis abgerechnet werden, müssen sie ihre Kalkulationen auf Basis des Einführungspreises von 2 $/10 $ verdoppeln. Für welche Kanäle der Einführungspreis gilt, hat Google bisher nicht eindeutig erklärt. Prüfen Sie daher vor der Anbindung die tatsächlichen Preise auf der Abrechnungsseite der Google-Cloud-Konsole.
Eine weitere leicht zu übersehende Änderung betrifft die Plattform selbst. Auf der Cloud-Next-Konferenz im April 2026 hat Google die Dienste von Vertex AI in die Gemini Enterprise Agent Platform integriert. Die Dokumentation der bisherigen Vertex-AI-Version wird nicht mehr aktualisiert. Bestehende Endpunkte bleiben verfügbar, aber Dokumentation und neue Funktionen für Modelle wie Argon werden vorrangig auf der Agent Platform erscheinen. Außerdem werden Gemini 2.5 Pro, 2.5 Flash und 2.5 Flash-Lite am 16. Oktober eingestellt. Teams, die diese Modelle noch nutzen, können die Gelegenheit nutzen, um die Migration gebündelt abzuschließen.
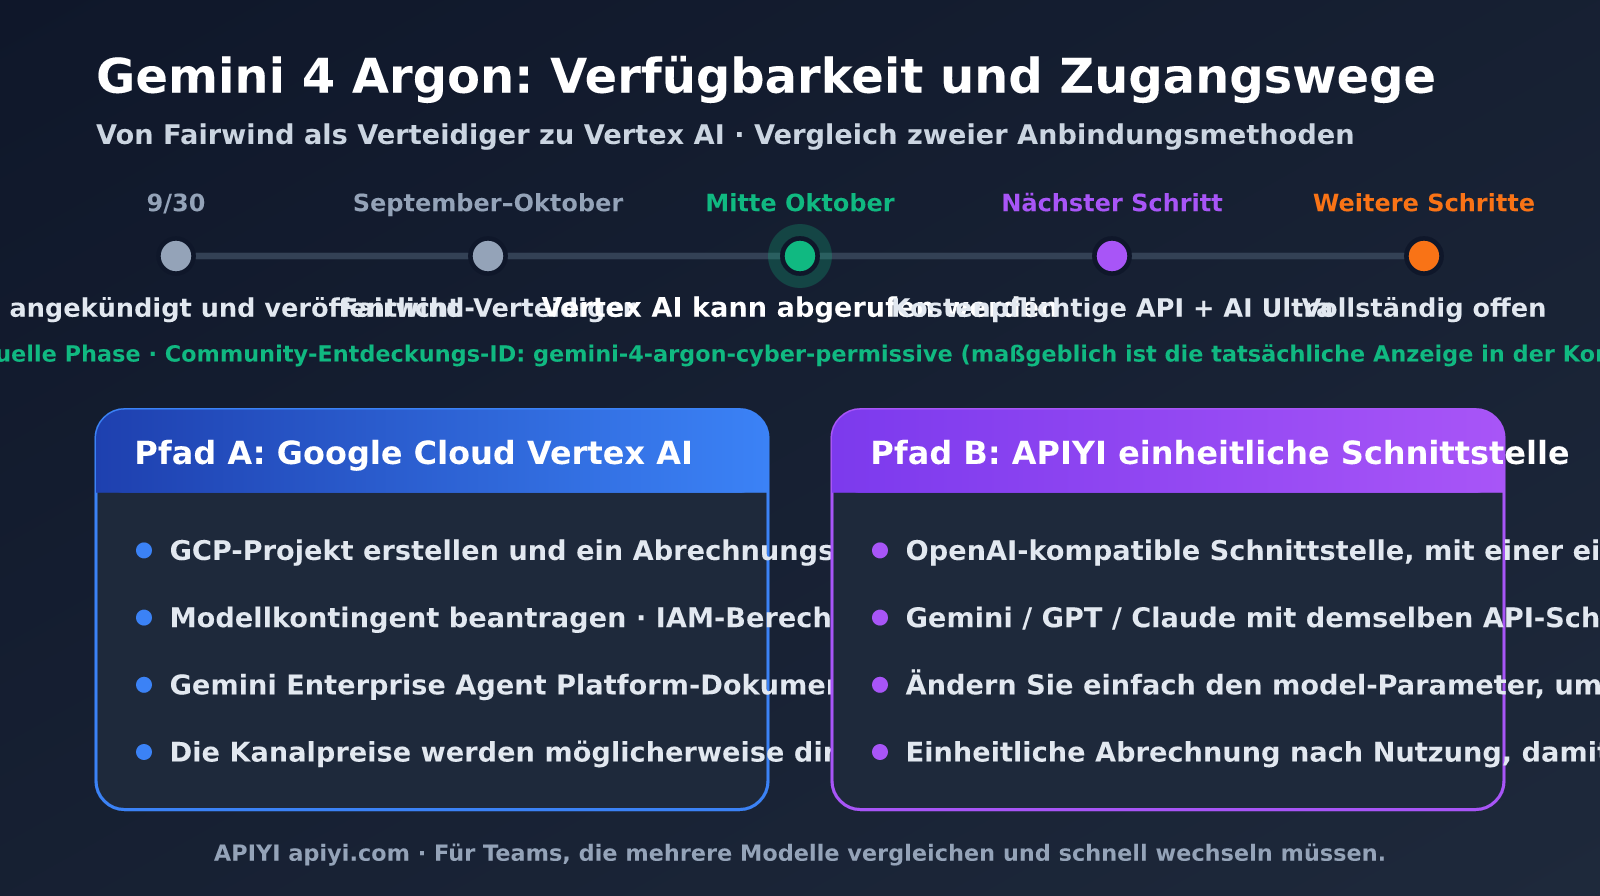
🚀 Tipp zur Anbindung: Für die direkte Nutzung von Vertex AI benötigen Sie ein GCP-Projekt, ein Abrechnungskonto, eine Kontingentfreigabe und eine IAM-Konfiguration – für kleine und mittlere Teams ist die Einstiegshürde daher recht hoch. Wir empfehlen, Gemini-Modelle zentral über die OpenAI-kompatible Schnittstelle der APIYI-Plattform apiyi.com anzubinden. Zum Wechsel zwischen Argon und anderen Modellen müssen Sie dann nur den Parameter
modeländern.
Gemini 4 Argon im Preisvergleich: Familienmitglieder und Konkurrenz
Der reine Preis pro Token sagt wenig darüber aus, ob Argon teuer ist. Dafür muss man das Modell mit dem Gemini 3.8 Flash aus derselben Familie und den Flaggschiffmodellen der Konkurrenz vergleichen. Die folgende Tabelle zeigt die Listenpreise. Die Preise der Konkurrenz stammen aus einer Zusammenstellung Dritter; maßgeblich sind die Angaben auf den offiziellen Seiten der jeweiligen Anbieter.
| Modell | Eingabe / 1 Mio. Token | Ausgabe / 1 Mio. Token | Maximale Ausgabe pro Anfrage | Positionierung |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | — | Für den Alltag, gutes Preis-Leistungs-Verhältnis |
| Gemini 4 Argon (Einführungspreis) | $2.00 | $10.00 | 1 Mio. | Flaggschiff für mehrstufiges Schlussfolgern |
| Gemini 4 Argon (regulärer Preis) | $4.00 | $20.00 | 1 Mio. | Flaggschiff für mehrstufiges Schlussfolgern |
| Claude Opus 5.5 | $4.00 | $20.00 | 128.000 | Flaggschiff der Konkurrenz |
| GPT-6 Astra | $10.00 | $50.00 | 128.000 | Flaggschiff der Konkurrenz |
Beim Preis pro Token kostet Argon zum Einführungspreis etwa 2,7-mal so viel wie Gemini 3.8 Flash. Der reguläre Preis entspricht dem von Claude Opus 5.5 und liegt bei 40 % des Preises von GPT-6 Astra. Doch der Preis pro Token ist nur die eine Hälfte der Rechnung. Die andere ist die Frage, wie viele Token für dieselbe Aufgabe benötigt werden – und genau hier liegt der wichtigste Unsicherheitsfaktor bei Argons Preisgestaltung.
Kosten pro Aufgabe bei Gemini 4 Argon: Der Tokenverbrauch ist entscheidend
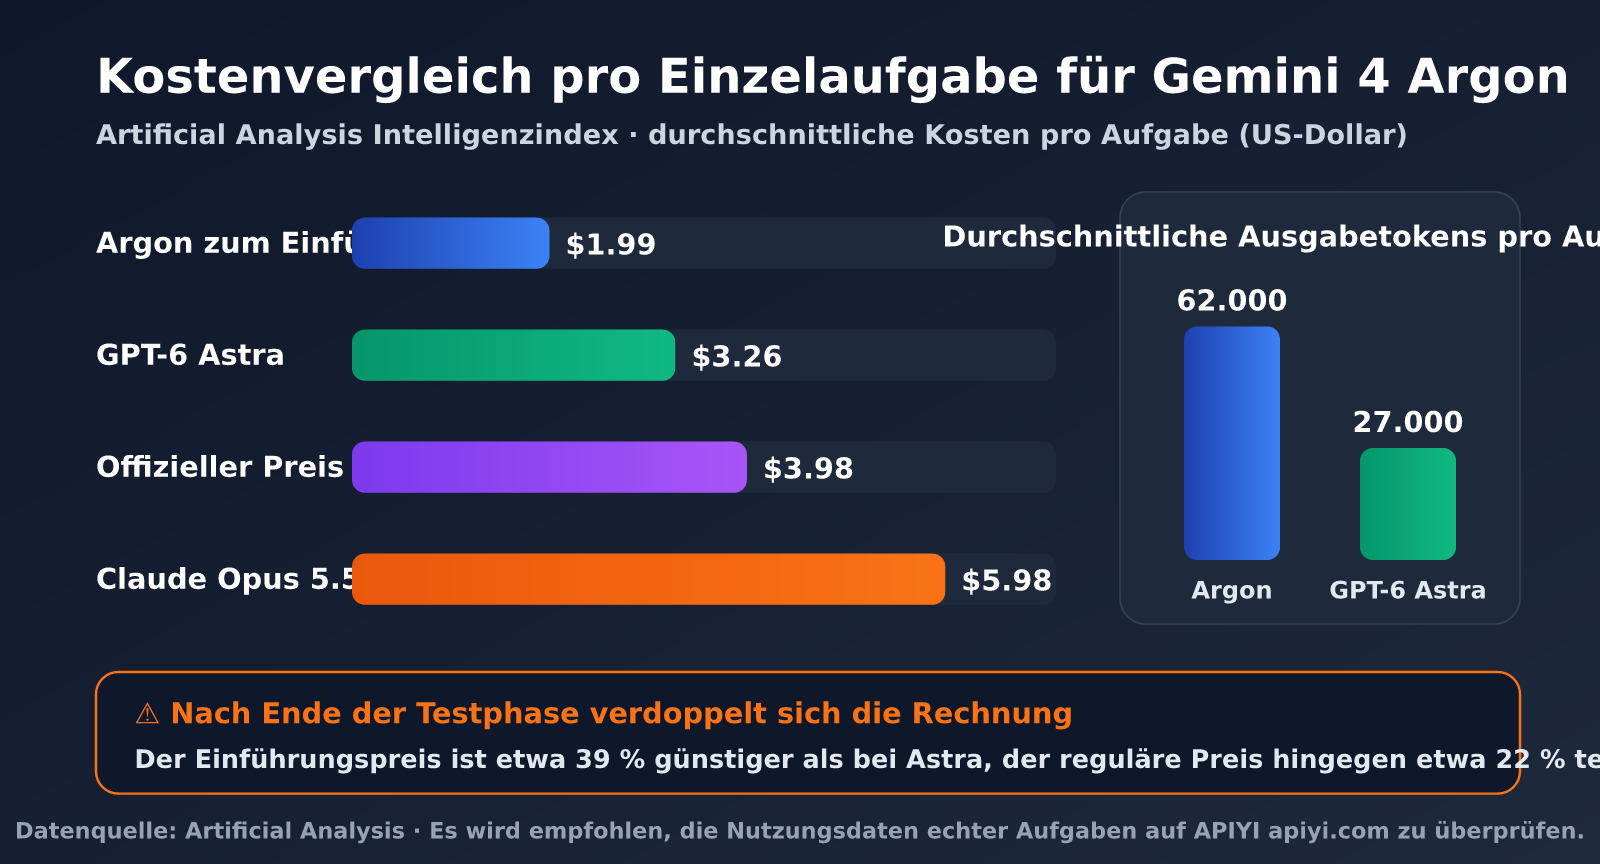
Die Kosten pro Aufgabe aus Tests unabhängiger Anbieter sagen mehr aus als der Preis pro Token. Laut Daten von Artificial Analysis erzeugt Argon im Intelligence-Index-Test durchschnittlich etwa 62.000 Ausgabetoken pro Aufgabe. GPT-6 Astra erzielte ein gleichwertiges Ergebnis mit nur rund 27.000 Token. Argon produziert also mehr als doppelt so viel „Text“ wie sein Konkurrent.
| Bewertungsgrundlage | Gemini 4 Argon | Vergleichsmodell | Fazit |
|---|---|---|---|
| AA-Kosten pro Aufgabe (Einführungspreis) | $1.99 | GPT-6 Astra $3.26 | Während der Einführungsphase etwa 39 % günstiger als Astra |
| AA-Kosten pro Aufgabe (regulärer Preis) | $3.98 | GPT-6 Astra $3.26 | Zum regulären Preis etwa 22 % teurer als Astra |
| AA-Kosten pro Aufgabe | $1.99 | Claude Opus 5.5 $5.98 | Etwa ein Drittel der Kosten von Opus 5.5 |
| Vals-Kosten pro Test | $15.68 | Opus 5.5 $32.14 / Sonnet 5.5 $21.34 | Bei dieser Arbeitslast die niedrigsten Kosten |
| Durchschnittliche Ausgabetoken pro Aufgabe | Etwa 62.000 | GPT-6 Astra etwa 27.000 | Argons Schlussfolgerungsprozess ist deutlich länger |
Die Tabelle macht den entscheidenden Punkt bei Gemini 4 Argon deutlich: Während der Einführungsphase bietet Argon ein sehr gutes Preis-Leistungs-Verhältnis. Nach deren Ende kann das Modell bei manchen Arbeitslasten sogar teurer sein als GPT-6 Astra, obwohl dessen Preis pro Token höher ist. Der Grund dafür ist der höhere Verbrauch an Ausgabetoken. Die Vals-Tests zeigen jedoch auch, dass Argon bei einer anderen Art von Arbeitslast die niedrigsten Kosten verursacht. Das Ergebnis hängt also stark von der konkreten Aufgabe ab – eigene Messungen sind unverzichtbar.
💡 Tipp zur Modellauswahl: Ein niedriger Preis pro Token bedeutet nicht automatisch eine niedrigere Rechnung. Testen Sie auf der APIYI-Plattform apiyi.com dieselben realen Aufgaben mit Argon und anderen Flaggschiffmodellen. Erfassen Sie für jede Anfrage das Feld
usageund richten Sie Ihre Routing-Strategie am tatsächlichen Tokenverbrauch statt am Listenpreis aus.
Reale Kosten für Gemini 4 Argon: fünf typische Szenarien
Anhand der von Google veröffentlichten Preise berechnen wir die Kosten pro Anfrage für fünf typische Szenarien – jeweils zum Einführungspreis und zum regulären Preis. Token für den Denkprozess werden dabei einheitlich als Ausgabetoken gezählt.
| Szenario | Eingabetoken | Ausgabetoken | Kosten zum Einführungspreis | Kosten zum regulären Preis |
|---|---|---|---|---|
| Alltägliche Fragen und Antworten | 20.000 | 5.000 | $0.09 | $0.18 |
| Analyse langer Dokumente | 200.000 | 50.000 | $0.90 | $1.80 |
| Agent-Programmierung (80 % Cache-Treffer) | 600.000 | 62.000 | $0.91 | $1.82 |
| Große Code-Migration | 300.000 | 400.000 | $4.60 | $9.20 |
| Volle Ausgabe von 1 Mio. Token | Vernachlässigbar | 1 Mio. | $10.00 | $20.00 |
Nehmen wir die Agent-Programmierung als Beispiel: Von 600.000 Eingabetoken werden 480.000 aus dem Cache abgerufen. Bei $0.10 pro Million Token kostet das nur $0.048. Die übrigen 120.000 Token werden mit $2 pro Million berechnet und kosten $0.24. Für 62.000 Ausgabetoken fallen bei $10 pro Million $0.62 an. Insgesamt ergibt das etwa $0.91. Bei einer hohen Cache-Trefferquote machen die Ausgabetoken damit fast 70 % der Gesamtkosten aus. Die Ausgabelänge zu begrenzen ist also wichtiger, als die Eingabe zu reduzieren.
Bei der großen Code-Migration und einer vollen Ausgabe von 1 Mio. Token ist besondere Vorsicht geboten. Die maximale Ausgabe von 1 Mio. Token ist Argons wichtigstes Verkaufsargument, doch eine vollständig ausgeschöpfte Ausgabe kostet zum regulären Preis $20. Sind die Zeitlimits des Clients ungünstig gesetzt, können fehlgeschlagene Anfragen automatisch wiederholt werden – und die Kosten verdoppeln sich. Für Teams, die täglich Hunderte lange Aufgaben ausführen, können solche versteckten Kosten die Monatsrechnung schnell aus dem Ruder laufen lassen.
Versteckte Kosten bei Gemini 4 Argon
Aus den obigen Berechnungen ergeben sich mehrere versteckte Kosten, auf die Sie beim Einsatz von Argon achten sollten:
- Mehr Token für Schlussfolgerungen: Argon erzeugt durchschnittlich mehr als doppelt so viele Ausgabetoken wie GPT-6 Astra. Der nach Ausgabetoken abgerechnete Denkprozess kann die Kosten pro Aufgabe deutlich erhöhen.
- Sehr lange Ausgaben und Wiederholungsversuche: Bei einer maximalen Ausgabe von 1 Mio. Token können ungünstige Zeitlimits im Client oder Load Balancer dazu führen, dass lange Anfragen fehlschlagen und wiederholt werden. Dadurch können sich die Kosten vervielfachen.
- Cache-Fehlzugriffe: Eine ungünstige Struktur der Eingabeaufforderung kann zu einer niedrigen Cache-Trefferquote führen. Dadurch geht der Rabatt von 95 % verloren.
- Ende der Einführungsphase: Alle Preise pro Token verdoppeln sich. Ein konkretes Enddatum ist nicht angegeben.
- Preisunterschiede je nach Bezugsquelle: Der auf Vertex AI angezeigte Preis kann bereits dem regulären Preis entsprechen und damit doppelt so hoch sein wie bei einer Berechnung mit dem Einführungspreis.
Kostensparender Einsatz von Gemini 4 Argon
Gegen die oben beschriebenen versteckten Kosten helfen vor allem drei Maßnahmen: Legen Sie für jede Anfrage ein klares Ausgabelimit fest, platzieren Sie stabile Inhalte am Anfang der Eingabeaufforderung, um die Cache-Trefferquote zu erhöhen, und wählen Sie das Modell passend zum Schwierigkeitsgrad der Aufgabe aus. Das folgende Beispiel verwendet eine OpenAI-kompatible Schnittstelle; die Modell-ID wird über eine Umgebungsvariable konfiguriert.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI-OpenAI-kompatible Schnittstelle
)

# Maßgeblich ist die Modell-ID, die in der Plattform oder der Vertex-AI-Konsole angezeigt wird
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")

resp = client.chat.completions.create(
    model=ARGON,
    max_tokens=16000,  # Ausgabelimit explizit setzen, statt standardmäßig bis zu 1M zuzulassen
    messages=[{"role": "user", "content": "分析这段代码的并发安全问题"}],
)
u = resp.usage
print(f"输入 {u.prompt_tokens} / 输出 {u.completion_tokens} token")
Vollständigen Code anzeigen: Routing nach Schwierigkeitsgrad und Kostenerfassung
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

# Modelle und Preise sind vollständig konfigurierbar. Nach der Testphase müssen nur die Umgebungsvariablen geändert werden.
ROUTES = {
    "easy": {
        "model": os.getenv("FLASH_MODEL", "gemini-3.8-flash"),
        "price_in": 0.75, "price_out": 3.75, "max_tokens": 8000,
    },
    "hard": {
        "model": os.getenv("ARGON_MODEL", "gemini-4-argon"),
        "price_in": float(os.getenv("ARGON_PRICE_IN", "2")),
        "price_out": float(os.getenv("ARGON_PRICE_OUT", "10")),
        "max_tokens": 64000,
    },
}

# Den stabilen Präfix an den Anfang stellen, um die Cache-Trefferquote zu erhöhen
SYSTEM_PREFIX = open("system_prompt.md", encoding="utf-8").read()


def classify(task: str) -> str:
    """Einfaches Beispiel: Lange Aufgaben sowie Migrationen und Audits an Argon weiterleiten, alle anderen an Flash"""
    keywords = ("迁移", "重构", "审计", "漏洞", "多文件")
    return "hard" if len(task) > 4000 or any(k in task for k in keywords) else "easy"


def run(task: str) -> str:
    route = ROUTES[classify(task)]
    resp = client.chat.completions.create(
        model=route["model"],
        max_tokens=route["max_tokens"],
        messages=[
            {"role": "system", "content": SYSTEM_PREFIX},
            {"role": "user", "content": task},
        ],
        timeout=600,  # Bei Aufgaben mit langen Ausgaben das Timeout erhöhen, damit fehlgeschlagene Wiederholungsversuche die Kosten nicht verdoppeln
    )
    u = resp.usage
    cost = (u.prompt_tokens * route["price_in"]
            + u.completion_tokens * route["price_out"]) / 1_000_000
    print(f"[{route['model']}] in={u.prompt_tokens} out={u.completion_tokens} "
          f"估算成本 ${cost:.4f}(未计缓存折扣)")
    return resp.choices[0].message.content


if __name__ == "__main__":
    print(run("把 legacy/ 目录下的 C 模块迁移为 Rust,并保持接口一致"))
Der Code veranschaulicht drei Prinzipien zum Kostensparen. Erstens: max_tokens explizit festlegen, statt sich auf ein großzügiges Standard-Ausgabelimit des Modells zu verlassen. Zweitens: Die System-Eingabeaufforderung als stabilen Präfix an den Anfang setzen, damit möglichst viele Anfragen über mehrere Gesprächsrunden hinweg den Cache nutzen können. Drittens: Nach Schwierigkeitsgrad routen. Einfache Aufgaben bleiben bei Gemini 3.8 Flash, dessen Preis pro Einheit nur etwa ein Drittel des Argon-Preises beträgt. Nur Aufgaben mit langen Verarbeitungsketten und hohem Schwierigkeitsgrad werden an Argon weitergeleitet.
Tipp: Sie können zunächst über APIYI unter apiyi.com ein Testguthaben beziehen und das Routing-Skript eine Woche lang mit echtem Anfragevolumen ausführen. Passen Sie anschließend anhand der Nutzungsprotokolle die Routing-Schwellenwerte und Ausgabelimits an.
Häufig gestellte Fragen
F1: Kostet Gemini 4 Argon aktuell 2/10 oder 4/20 US-Dollar?
Der von Google offiziell veröffentlichte Einführungspreis liegt bei 2/10 US-Dollar, der reguläre Preis bei 4/20 US-Dollar. Google hat jedoch weder angegeben, wie lange die Einführungsphase dauert, noch ob alle Anbieter den Einführungspreis einheitlich anwenden. Laut Berichten aus der Community zeigt Vertex AI den regulären Preis von 4/20 US-Dollar an. Maßgeblich ist der tatsächliche Preis auf der Rechnung Ihres Zugangskanals. Planen Sie Ihr Budget vorsichtshalber mit beiden Preisstufen.
F2: Lässt sich `gemini-4-argon-cyber-permissive` auf Vertex AI direkt verwenden?
Dem Namen nach handelt es sich um eine Version für die Cyberabwehr, bei der die Sicherheitsbeschränkungen im Bereich Cybersicherheit gelockert sind. Sie ist an Zugriffsrechte aus dem Fairwind-Programm gebunden; gewöhnliche Projekte haben in der Regel keine Berechtigung, das Modell aufzurufen. Als zahlender Kunde sollten Sie sich nach der Modell-ID richten, die in der Model-Garden-Ansicht Ihrer Konsole angezeigt wird. Wenn Sie sich nicht mit GCP-Projekten, Kontingenten und Berechtigungen befassen möchten, können Sie Gemini-Modelle auch über einen Aggregator wie den API-Proxy-Dienst APIYI unter apiyi.com aufrufen.
F3: Werden die Reasoning-Token von Argon zusätzlich berechnet?
Google hat dazu noch keine separate Auskunft gegeben. Bei den bestehenden Gemini-Modellen werden Reasoning-Token zum Ausgabepreis berechnet; für die Budgetplanung empfiehlt sich daher dieselbe Annahme. Da Argon im Durchschnitt mehr Token ausgibt, machen Reasoning-Token oft einen großen Teil der Kosten aus. Mit `max_tokens` und einer angepassten Reasoning-Stärke können Sie die Ausgaben kontrollieren.
F4: Bei welchen Aufgaben lohnt sich Gemini 4 Argon?
Bei Aufgaben mit langen Verarbeitungsketten, etwa umfangreichen Code-Migrationen, der fachlichen Analyse langer Dokumente, Agenten für Recht und Finanzen sowie Sicherheitsaudits, kommen Argons Stärken besonders zur Geltung. Hier kann sich der Preis lohnen. Für alltägliche Fragen, einfache Codevervollständigungen und leichte Aufgaben mit hohem Anfragevolumen sind günstigere Modelle wie Gemini 3.8 Flash meist wirtschaftlicher. Am besten vergleichen Sie echte Aufgaben per A/B-Test auf der Plattform von APIYI unter apiyi.com und legen erst danach das Routing-Verhältnis fest.
Zusammenfassung
Der Preis von Gemini 4 Argon lässt sich als „günstiger Listenpreis, viele Unwägbarkeiten“ zusammenfassen. Der Einführungspreis von 2 $/10 $ ist für ein Flaggschiffmodell sehr konkurrenzfähig. Auch der Cache-Rabatt von 95 % ist besonders für Agenten-Szenarien attraktiv. Allerdings können der hohe Verbrauch an Reasoning-Tokens, die Verdopplung des Preises nach Ende der Einführungsphase und die Möglichkeit, dass über Vertex AI sofort der reguläre Preis gilt, dazu führen, dass die tatsächliche Rechnung deutlich von den Erwartungen auf Basis des Listenpreises abweicht.
Da Gemini 4 Argon inzwischen über Vertex AI verfügbar ist, sollte der nächste Schritt nicht darin bestehen, möglichst schnell vollständig umzustellen. Messen Sie stattdessen zunächst anhand realer Anfragen, wie sich der Tokenverbrauch verteilt. Anschließend können Sie die Kosten über Ausgabelimits, Cache-Präfixe und eine Routing-Strategie nach Aufgabenschwierigkeit kontrollieren. Wir empfehlen, Argon als Flaggschiffmodell für besonders schwierige Aufgaben einzusetzen und mit Modellen der Flash-Klasse zu kombinieren.
Wir empfehlen, die Gemini-Modelle zentral über die Plattform APIYI apiyi.com anzubinden. So können Sie Argon und andere Modelle über dieselbe Schnittstelle hinsichtlich Kosten und Leistung vergleichen und Ihre Modellstrategie auf Grundlage realer Daten statt der Listenpreise festlegen.
Quellen:
- Offizieller Google-Blogbeitrag zur Veröffentlichung von Gemini 4 Argon: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Informationsseite zum Google Fairwind Program: deepmind.google/fairwind-program
- Benchmark- und Preisübersicht zu Gemini 4 Argon von DataCamp: datacamp.com/blog/gemini-4-argon
- Modellkosten und Intelligence Index von Artificial Analysis: artificialanalysis.ai
- Modellbewertungen und Kostendaten von Vals AI: vals.ai
Autor: APIYI Team | Wir verfolgen laufend die Preise und Anbindungsmöglichkeiten großer Sprachmodelle. Weitere Informationen zur Anbindung von KI-Modellen finden Sie unter APIYI apiyi.com