شهد Gemini 4 Argon تطورًا جديدًا: فبعد الإعلان عنه رسميًا في 30 سبتمبر وإتاحته أولًا لجهات الدفاع السيبراني ضمن برنامج Fairwind، أصبح نموذج Gemini 4 Argon متاحًا الآن للاستدعاء عبر Vertex AI، وبدأت Google Cloud رسميًا توسيع نطاق إتاحته. بالنسبة إلى معظم المطورين، يبرز الآن سؤال عملي: كيف تُحسب تكلفة Gemini 4 Argon، وكم سيبلغ الإنفاق الشهري بعد دمجه في التطبيقات؟
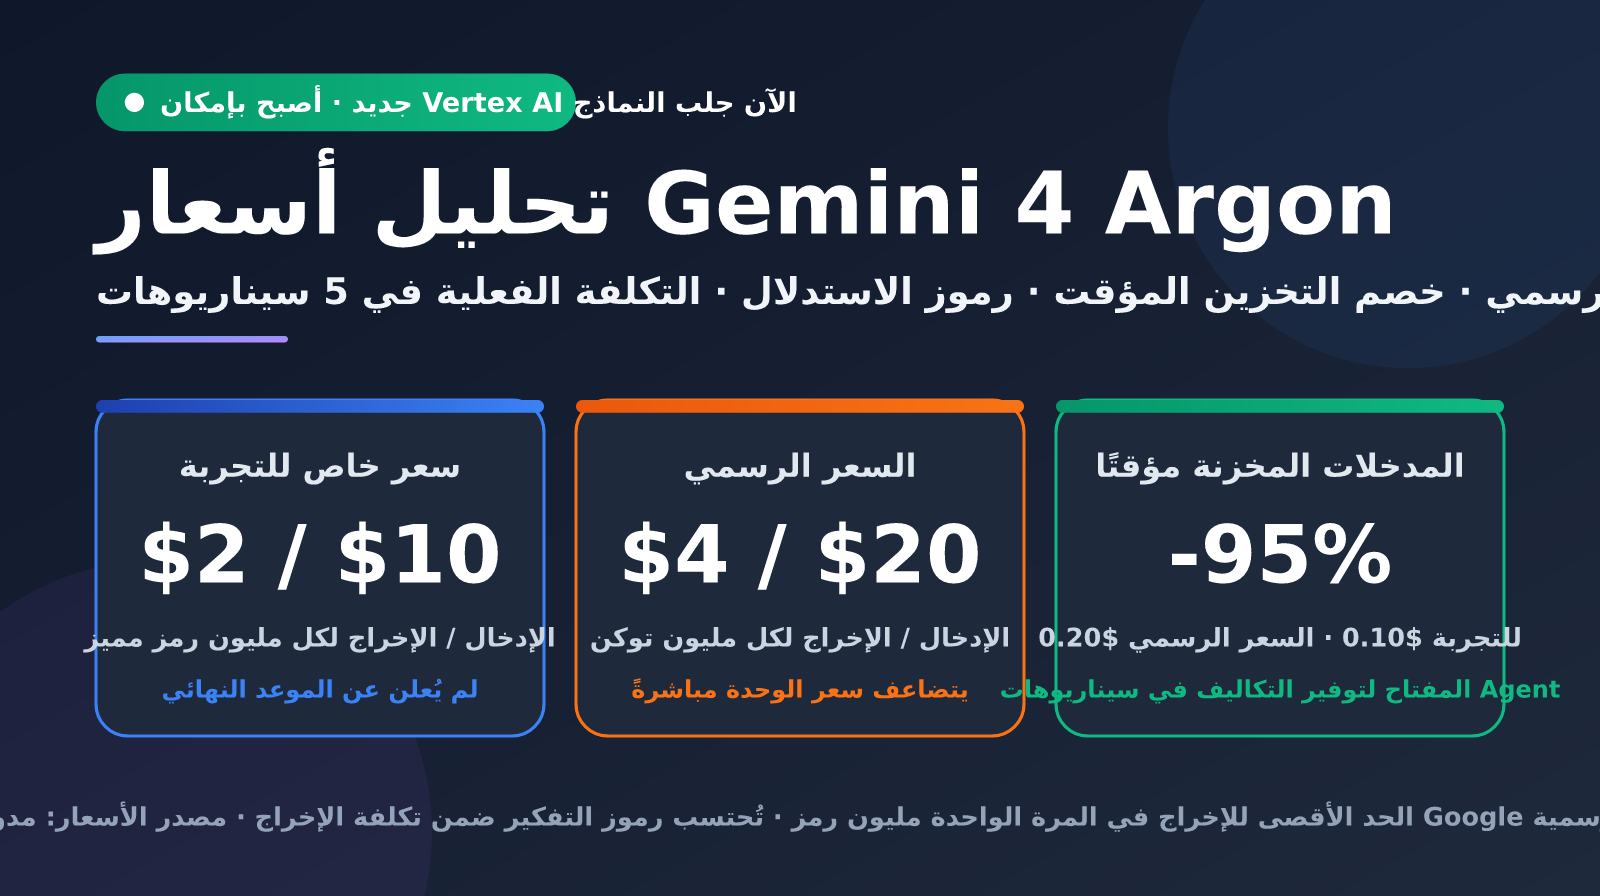
قد تبدو الأسعار بسيطة للوهلة الأولى: دولاران للإدخال و10 دولارات للإخراج لكل مليون رمز خلال فترة الإتاحة المبكرة، ثم تتضاعف إلى 4 و20 دولارًا على التوالي عند اعتماد الأسعار الرسمية، مع خصم 95% على الإدخال المخزّن مؤقتًا. لكن وراء هذه القائمة عدة عوامل مؤثرة: كيف تُحتسب رموز الاستدلال؟ وهل يمكن أن يؤدي الحد الأقصى البالغ مليون رمز للإخراج إلى ارتفاع تكلفة الطلب الواحد؟ وكم يزيد استهلاك Argon من الرموز مقارنةً بالمنافسين؟ في هذا المقال، نستند إلى منشور Google الرسمي وبيانات منشورة من وسائل إعلام إنجليزية متعددة وجهات تقييم مستقلة، لنحلل أسعار Gemini 4 Argon بندًا بندًا، ونقدّر التكلفة في خمسة سيناريوهات شائعة.
الفائدة الأساسية: بعد قراءة هذا المقال، ستتمكن من حساب التكلفة الفعلية لكل مهمة باستخدام Gemini 4 Argon في عملك، ومعرفة كيف ستتغير الفاتورة بعد انتهاء فترة الإتاحة المبكرة، وكيفية خفض التكاليف بالاستفادة من التخزين المؤقت وتحديد حد أقصى للإخراج.
نظرة سريعة على أسعار Gemini 4 Argon
لنبدأ بتلخيص الأسعار التي أعلنتها Google رسميًا في جدول. تجدر الإشارة إلى أن Google أعلنت عن فئتين فقط: أسعار الإتاحة المبكرة والأسعار الرسمية. ولم توضّح مدة فترة الإتاحة المبكرة، كما لم تنشر تفاصيل أسعار المعالجة المجمّعة (Batch) أو Flex أو فئات السياق الطويل أو رسوم تخزين البيانات مؤقتًا.
| بند الفوترة | سعر الإتاحة المبكرة (لكل مليون رمز) | السعر الرسمي (لكل مليون رمز) | ملاحظات |
|---|---|---|---|
| الإدخال | $2.00 | $4.00 | لم تُعلن مدة فترة الإتاحة المبكرة |
| الإخراج | $10.00 | $20.00 | لم توضّح Google رسميًا طريقة فوترة رموز الاستدلال على نحو منفصل |
| الإدخال المخزّن مؤقتًا | $0.10 | $0.20 | خصم 95% من سعر الإدخال؛ وقد استُنتج السعر الرسمي على أساس الخصم نفسه |
| الحد الأقصى للإخراج في الطلب الواحد | مليون رمز | مليون رمز | كان الحد الأقصى في نماذج Gemini السابقة 64 ألف رمز |
| Batch / Flex | لم يُعلن | لم يُعلن | تتضمن نماذج Gemini الحالية عادةً خصمًا للمعالجة المجمّعة |
| فئات السياق الطويل | لم تُعلن | لم تُعلن | لم تُعلن Google أيضًا عن نافذة سياق الإدخال |
ثلاثة تفاصيل أساسية عن أسعار Gemini 4 Argon
التفصيل الأول هو رموز الاستدلال. لم توضّح Google على نحو منفصل كيفية احتساب تكلفة رموز التفكير في Argon، لكن المتّبع في سلسلة Gemini حاليًا هو فوترة رموز التفكير بسعر الإخراج. ولإعداد الميزانية، من الأكثر أمانًا افتراض أن Argon يتبع القاعدة نفسها؛ أي إن جميع مراحل التفكير تُحتسب ضمن الفاتورة بسعر 10 دولارات (خلال فترة الإتاحة المبكرة) أو 20 دولارًا (بالسعر الرسمي) لكل مليون رمز.
التفصيل الثاني هو خصم التخزين المؤقت. يعني خصم 95% أن تكلفة الإدخال المخزّن مؤقتًا خلال فترة الإتاحة المبكرة تبلغ 0.10 دولار فقط لكل مليون رمز. وفي مسارات العمل المعتمدة على الوكلاء، يُعاد إرسال موجه النظام وتعريفات الأدوات وسياق قاعدة الشفرة في كل جولة من المحادثة. وغالبًا ما تتجاوز نسبة نجاح التخزين المؤقت 70%، لذا قد يكون أثر هذا الخصم في الفاتورة الإجمالية أكبر من أثر السعر الأساسي البالغ دولارين.
التفصيل الثالث هو عدم اليقين بشأن فترة الإتاحة المبكرة. فبمجرد انتهائها، تتضاعف جميع الأسعار مباشرةً، ولم تحدد Google موعدًا لانتهائها. لذلك، إذا أعددت حسابات العائد على الاستثمار بالاستناد إلى أسعار الإتاحة المبكرة، فمن الأفضل إعداد نسخة أخرى وفق الأسعار الرسمية أيضًا، لتجنب مفاجأة تضاعف الفاتورة في أحد الأيام.
🎯 نصيحة لإعداد الميزانية: تتعدد العوامل المؤثرة في تكلفة Gemini 4 Argon؛ لذا يُنصح ببدء التشغيل على نطاق محدود لرصد التوزيع الفعلي لاستهلاك الرموز قبل اتخاذ قرار التوسع. ويمكنك عبر منصة APIYI على apiyi.com استدعاء نماذج Gemini وGPT وClaude وغيرها من خلال واجهة موحّدة، ما يسهّل مقارنة التكاليف الفعلية باستخدام المجموعة نفسها من المهام.
أحدث مستجدات إطلاق Gemini 4 Argon على Vertex AI
لطالما كان موعد إتاحة Argon من أكثر الأمور التي تشغل المطورين. ووفقًا للخطة الواردة في مدونة Google، سيُتاح Argon أولًا للجهات الموثوقة المعنية بالدفاع السيبراني ضمن برنامج Fairwind ولموظفي Google، ثم لعملاء API المدفوعين ومشتركي Google AI Ultra، وأخيرًا لشريحة أوسع من المطورين والشركات والمستهلكين. يوضح الجدول التالي مراحل الإتاحة، من الإعلان الرسمي حتى ظهور النموذج على Vertex AI.
| التاريخ | الحدث | المصدر |
|---|---|---|
| 3 سبتمبر | إطلاق برنامج Fairwind، وكان Gemini 3.8 Flash Cyber أول نموذج فيه | مدونة Google الرسمية |
| 30 سبتمبر | الإعلان رسميًا عن Gemini 4 Argon وإتاحته لأعضاء Fairwind | مدونة Google الرسمية |
| 30 سبتمبر | تحقق DataCamp: لم يكن النموذج متاحًا على Vertex AI أو Gemini CLI وغيرها | DataCamp |
| 7–8 أكتوبر | رصد أفراد من المجتمع إدخال gemini-4-argon-cyber-permissive على Vertex AI |
المجتمع ووسائل إعلام تقنية |
| منتصف أكتوبر | أصبح بالإمكان الوصول إلى نموذج Gemini 4 Argon على Vertex AI | أحدث المستجدات |
ومن اللافت أن المعرّف gemini-4-argon-cyber-permissive هو أول ما رصده أفراد المجتمع. وتشير كلمة «cyber-permissive» إلى أن هذه النسخة موجّهة للجهات المعنية بالدفاع السيبراني، مع تخفيف قيود الأمان المتعلقة بالأمن السيبراني. وهذا يتوافق مع وصف مدونة Google للنسخة المخصصة للجهات الدفاعية الموثوقة، والتي لا تفرض عليها هذه القيود. ومن المرجح أن تستخدم النسخة المخصصة للعملاء العاديين الذين يدفعون مقابل الخدمة معرّفًا مختلفًا، وأن تحتفظ بإجراءات الحماية الأمنية كاملة. لذلك، عند الربط، اعتمد معرّف النموذج الظاهر فعليًا في Model Garden ضمن وحدة تحكم Google Cloud الخاصة بك، ولا تستخدم مباشرةً الأسماء المتداولة على الإنترنت.
أسعار Gemini 4 Argon والتغييرات في منصة Vertex AI
تفيد معلومات متداولة بين أفراد المجتمع بأن السعر العالمي لـ Argon الظاهر على Vertex AI هو 4 دولارات لكل مليون رمز إدخال، و20 دولارًا لكل مليون رمز إخراج، أي وفق شريحة السعر الرسمية الواردة في مدونة Google. وهذه نقطة تستحق الانتباه: إذا كان استخدام الشركات للنموذج عبر Vertex AI يُحاسب مباشرةً بالسعر الرسمي، فينبغي مضاعفة التقديرات المبنية على السعر التجريبي البالغ 2/10 دولارات. ولم توضح Google حتى الآن القنوات التي ينطبق عليها السعر التجريبي؛ لذا تحقّق من السعر الفعلي في صفحة الفوترة بوحدة التحكم قبل بدء الاستخدام.
وهناك تغيير آخر يسهل إغفاله، وهو التغيير الذي طرأ على المنصة نفسها. ففي مؤتمر Cloud Next في أبريل 2026، دمجت Google خدمات Vertex AI في Gemini Enterprise Agent Platform، وأشارت وثائق Vertex AI القديمة إلى أنها لم تعد تتلقى تحديثات. وستظل نقاط النهاية الحالية متاحة، لكن وثائق النماذج الجديدة مثل Argon وميزاتها ستظهر أولًا على الأرجح في Agent Platform. كذلك ستُحال نماذج Gemini 2.5 Pro و2.5 Flash و2.5 Flash-Lite إلى التقاعد في 16 أكتوبر. ويمكن للفرق التي ما زالت تستخدم هذه الإصدارات الاستفادة من هذه الفرصة لإتمام عملية الانتقال دفعة واحدة.
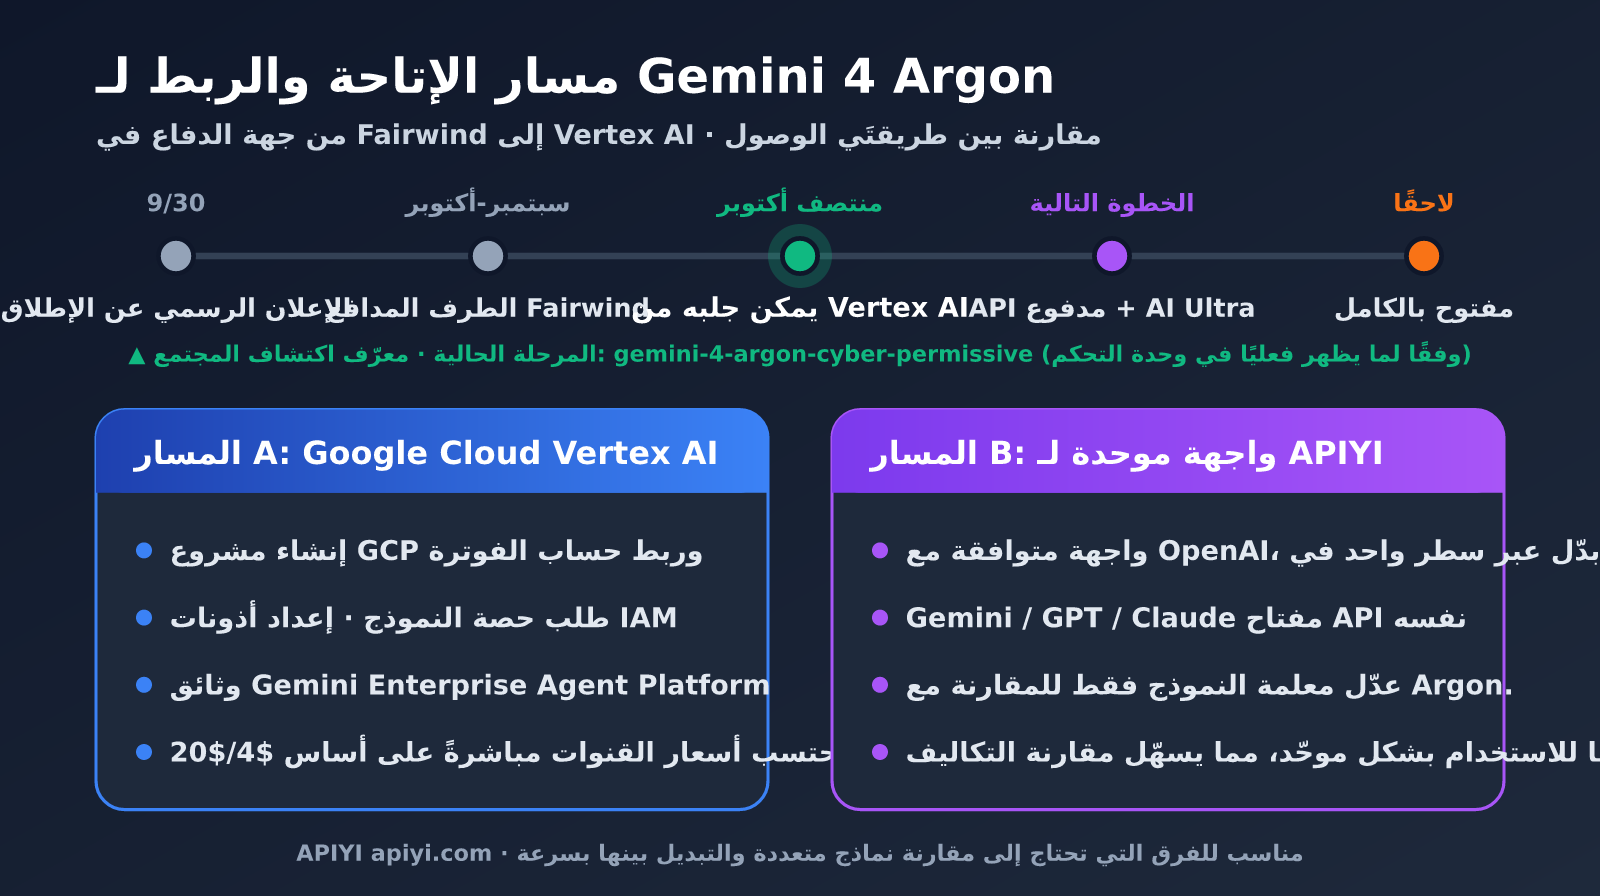
🚀 نصيحة للربط: يتطلب الربط المباشر عبر Vertex AI مشروعًا على GCP، وحساب فوترة، وطلب حصة استخدام، وإعداد IAM؛ وهي متطلبات قد تشكل عائقًا أمام الفرق الصغيرة والمتوسطة. نوصي باستخدام واجهة متوافقة مع OpenAI عبر منصة APIYI apiyi.com للربط الموحد بنماذج Gemini. يكفي تغيير معامل
modelللتبديل بين Argon والنماذج الأخرى.
مقارنة أسعار Gemini 4 Argon: مقارنة مع نماذج العائلة والمنافسين
يصعب الحكم على مدى ارتفاع سعر Argon بالنظر إلى سعر الوحدة وحده. لذا، من الأفضل مقارنته بنموذج Gemini 3.8 Flash من العائلة نفسها وبالنماذج الرائدة لدى المنافسين. يوضح الجدول التالي الأسعار المعلنة؛ أما أسعار المنافسين فجمعتها جهة خارجية، لذا يُرجى الرجوع إلى الصفحات الرسمية لكل شركة للتحقق منها.
| النموذج | الإدخال / مليون توكن | الإخراج / مليون توكن | الحد الأقصى للإخراج في المرة الواحدة | الاستخدام |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | — | للاستخدام اليومي، قيمة ممتازة مقابل السعر |
| Gemini 4 Argon (السعر التمهيدي) | $2.00 | $10.00 | 1M | نموذج رائد للاستدلال متعدد المراحل |
| Gemini 4 Argon (السعر الرسمي) | $4.00 | $20.00 | 1M | نموذج رائد للاستدلال متعدد المراحل |
| Claude Opus 5.5 | $4.00 | $20.00 | 128K | نموذج رائد منافس |
| GPT-6 Astra | $10.00 | $50.00 | 128K | نموذج رائد منافس |
من حيث سعر الوحدة، يبلغ السعر التمهيدي لـ Argon نحو 2.7 ضعف سعر Gemini 3.8 Flash، بينما يساوي سعره الرسمي سعر Claude Opus 5.5، ولا يتجاوز 40% من سعر GPT-6 Astra. لكن سعر الوحدة ليس سوى نصف الصورة؛ أما النصف الآخر فهو عدد التوكنات اللازمة لإنجاز المهمة نفسها، وهنا تكمن النقطة الأهم التي تستدعي الانتباه عند النظر إلى تسعير Argon.
تكلفة المهمة الواحدة في Gemini 4 Argon: استهلاك التوكنات هو العامل الحاسم
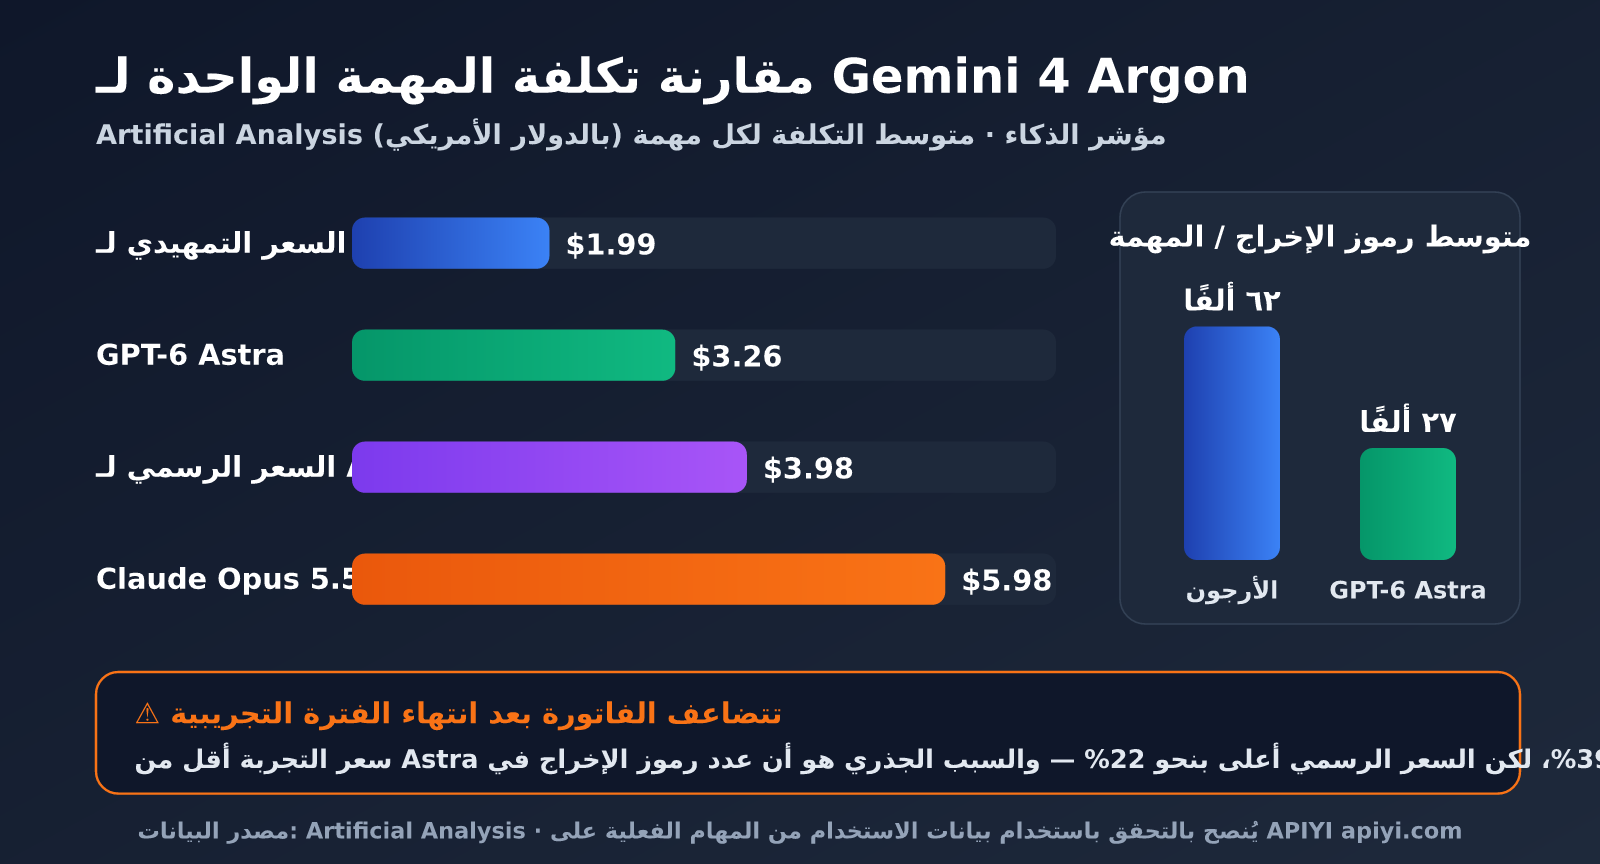
توضح تكلفة المهمة الواحدة التي ترصدها جهات تقييم خارجية الصورة أكثر من سعر الوحدة. فبحسب بيانات Artificial Analysis، يولّد Argon في المتوسط نحو 62 ألف توكن إخراج لكل مهمة في اختبار مؤشر الذكاء، بينما استخدم GPT-6 Astra نحو 27 ألف توكن فقط لتحقيق النتيجة نفسها؛ أي إن Argon ينتج أكثر من ضعف حجم مخرجات منافسه.
| معيار التقييم | Gemini 4 Argon | النموذج المقارن | الخلاصة |
|---|---|---|---|
| تكلفة المهمة لدى AA (السعر التمهيدي) | $1.99 | GPT-6 Astra: $3.26 | أقل من Astra بنحو 39% خلال الفترة التمهيدية |
| تكلفة المهمة لدى AA (السعر الرسمي) | $3.98 | GPT-6 Astra: $3.26 | أعلى من Astra بنحو 22% عند تطبيق السعر الرسمي |
| تكلفة المهمة لدى AA | $1.99 | Claude Opus 5.5: $5.98 | نحو ثلث تكلفة Opus 5.5 |
| تكلفة الاختبار الواحد لدى Vals | $15.68 | Opus 5.5: $32.14 / Sonnet 5.5: $21.34 | الأقل تكلفة ضمن عبء العمل هذا |
| متوسط توكنات الإخراج لكل مهمة | نحو 62 ألفًا | GPT-6 Astra: نحو 27 ألفًا | عملية الاستدلال لدى Argon أطول بوضوح |
يكشف الجدول أهم نقطة في تسعير Gemini 4 Argon: يقدم Argon قيمة ممتازة مقابل السعر خلال الفترة التمهيدية، لكن بعد انتهائها قد يصبح، في بعض أعباء العمل، أغلى من GPT-6 Astra رغم أن سعر الوحدة لديه أعلى. والسبب هو استهلاكه عددًا أكبر من توكنات الإخراج. في المقابل، أظهرت اختبارات Vals أن Argon هو الأقل تكلفة في نوع آخر من أعباء العمل. وهذا يعني أن النتيجة تعتمد بدرجة كبيرة على طبيعة المهمة، لذا لا بد من حساب التكلفة باستخدام بياناتك الفعلية.
💡 نصيحة لاختيار النموذج: انخفاض سعر الوحدة لا يعني بالضرورة انخفاض الفاتورة. يُنصح باستخدام مجموعة المهام الفعلية نفسها على Argon والنماذج الرائدة الأخرى عبر منصة APIYI apiyi.com، وتسجيل حقل
usageلكل طلب. اعتمد على استهلاك التوكنات الفعلي، لا على الأسعار المعلنة، عند تحديد استراتيجية توجيه الطلبات.
التكلفة الفعلية لـ Gemini 4 Argon: تقدير 5 سيناريوهات شائعة
استنادًا إلى الأسعار التي أعلنتها Google، نقدّر هنا تكلفة الطلب الواحد في 5 سيناريوهات شائعة، وفق السعر التجريبي والسعر الرسمي. وتُحتسب رموز التفكير ضمن رموز الإخراج.
| السيناريو | رموز الإدخال | رموز الإخراج | التكلفة بالسعر التجريبي | التكلفة بالسعر الرسمي |
|---|---|---|---|---|
| الأسئلة والأجوبة اليومية | 20 ألفًا | 5000 | $0.09 | $0.18 |
| تحليل مستند طويل | 200 ألف | 50 ألفًا | $0.90 | $1.80 |
| البرمجة باستخدام الوكلاء (معدل إصابة ذاكرة التخزين المؤقت 80%) | 600 ألف | 62 ألفًا | $0.91 | $1.82 |
| ترحيل برمجي واسع النطاق | 300 ألف | 400 ألف | $4.60 | $9.20 |
| إخراج كامل بسعة 1M | لا يُذكر | مليون | $10.00 | $20.00 |
لنأخذ البرمجة باستخدام الوكلاء مثالًا: من أصل 600 ألف رمز إدخال، تُصاب 480 ألفًا في ذاكرة التخزين المؤقت، فتبلغ تكلفتها $0.048 فقط، وفق سعر $0.10. أما الرموز الـ120 ألفًا المتبقية، فتُحتسب بسعر $2 لتبلغ تكلفتها $0.24. وتبلغ تكلفة 62 ألف رمز إخراج، بسعر $10، نحو $0.62. وبذلك يصل الإجمالي إلى نحو $0.91. يتضح هنا أن رموز الإخراج تمثل قرابة 70% من التكلفة الإجمالية عند الاستفادة الجيدة من التخزين المؤقت؛ لذا فإن الحد من طول الإخراج أهم من تقليل الإدخال.
يتطلب سيناريو الترحيل البرمجي واسع النطاق وسيناريو الإخراج الكامل بسعة 1M أكبر قدر من الحذر. فحد الإخراج البالغ 1M هو أبرز مزايا Argon، لكن إخراجًا كاملًا بهذا الحجم يكلف $20 بالسعر الرسمي. وإذا أدى ضبط مهلة العميل على نحو غير مناسب إلى فشل الطلب وإعادة المحاولة تلقائيًا، فستتضاعف التكلفة مباشرة. وبالنسبة إلى الفرق التي تنفّذ مئات المهام الطويلة يوميًا، قد تؤدي هذه التكاليف الخفية بسهولة إلى خروج الفاتورة الشهرية عن السيطرة.
قائمة التكاليف الخفية لـ Gemini 4 Argon
استنادًا إلى التقديرات السابقة، انتبه عند استخدام Argon إلى أنواع التكاليف الخفية التالية:
- تضخم رموز الاستدلال: يتجاوز متوسط عدد رموز الإخراج في Argon ضعفي نظيره في GPT-6 Astra. وبما أن عملية التفكير تُحتسب وفق سعر الإخراج، فقد ترفع تكلفة المهمة الواحدة بوضوح.
- الإخراج الطويل جدًا وإعادة المحاولة: مع حد إخراج يبلغ 1M، قد يؤدي ضبط مهل الانتظار في العميل أو موازن التحميل على نحو غير مناسب إلى فشل الطلبات الطويلة وإعادة المحاولة، ما يضاعف التكلفة.
- عدم إصابة ذاكرة التخزين المؤقت: قد يؤدي سوء تنظيم الموجه إلى انخفاض معدل الإصابة في ذاكرة التخزين المؤقت، فتفقد خصمًا قدره 95% دون داعٍ.
- انتهاء الفترة التجريبية: تتضاعف جميع الأسعار، من دون تحديد موعد واضح لانتهاء الفترة.
- اختلاف الأسعار بين القنوات: قد يعرض Vertex AI السعر الرسمي مباشرةً، ما يعني أن تكلفته قد تبلغ ضعفي التقدير المبني على السعر التجريبي.
ممارسات لخفض تكلفة استخدام Gemini 4 Argon
لمواجهة التكاليف الخفية المذكورة أعلاه، تتمثل أكثر الطرق فاعلية في تحديد حد واضح للإخراج في كل طلب، ووضع المحتوى الثابت في بداية الموجه لزيادة معدل الإصابة في ذاكرة التخزين المؤقت، وتوجيه المهام إلى النماذج بحسب مستوى صعوبتها. يستخدم المثال أدناه واجهة متوافقة مع OpenAI، مع ضبط معرّف النموذج عبر متغيرات البيئة.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# 模型 ID 以平台或 Vertex AI 控制台实际显示为准
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")

resp = client.chat.completions.create(
    model=ARGON,
    max_tokens=16000,  # 显式设置输出上限,避免默认放开到 1M
    messages=[{"role": "user", "content": "分析这段代码的并发安全问题"}],
)
u = resp.usage
print(f"输入 {u.prompt_tokens} / 输出 {u.completion_tokens} token")
عرض الشفرة الكاملة: التوجيه بحسب الصعوبة وتسجيل التكلفة
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

# 模型与单价全部配置化,尝鲜期结束后只需改环境变量
ROUTES = {
    "easy": {
        "model": os.getenv("FLASH_MODEL", "gemini-3.8-flash"),
        "price_in": 0.75, "price_out": 3.75, "max_tokens": 8000,
    },
    "hard": {
        "model": os.getenv("ARGON_MODEL", "gemini-4-argon"),
        "price_in": float(os.getenv("ARGON_PRICE_IN", "2")),
        "price_out": float(os.getenv("ARGON_PRICE_OUT", "10")),
        "max_tokens": 64000,
    },
}

# 稳定前缀放在最前面,提升缓存命中率
SYSTEM_PREFIX = open("system_prompt.md", encoding="utf-8").read()


def classify(task: str) -> str:
    """简单示例:长任务、迁移、审计类任务走 Argon,其余走 Flash"""
    keywords = ("迁移", "重构", "审计", "漏洞", "多文件")
    return "hard" if len(task) > 4000 or any(k in task for k in keywords) else "easy"


def run(task: str) -> str:
    route = ROUTES[classify(task)]
    resp = client.chat.completions.create(
        model=route["model"],
        max_tokens=route["max_tokens"],
        messages=[
            {"role": "system", "content": SYSTEM_PREFIX},
            {"role": "user", "content": task},
        ],
        timeout=600,  # 长输出任务放宽超时,避免失败重试导致成本翻倍
    )
    u = resp.usage
    cost = (u.prompt_tokens * route["price_in"]
            + u.completion_tokens * route["price_out"]) / 1_000_000
    print(f"[{route['model']}] in={u.prompt_tokens} out={u.completion_tokens} "
          f"估算成本 ${cost:.4f}(未计缓存折扣)")
    return resp.choices[0].message.content


if __name__ == "__main__":
    print(run("把 legacy/ 目录下的 C 模块迁移为 Rust,并保持接口一致"))
تجسّد هذه الشفرة ثلاثة مبادئ لخفض التكلفة. أولًا، حدّد max_tokens صراحةً، ولا تعتمد على حد الإخراج الضخم الافتراضي للنموذج. ثانيًا، ضع موجه النظام في بداية الطلب كبادئة ثابتة، كي تزيد فرص إصابة الطلبات المتتابعة في ذاكرة التخزين المؤقت. وثالثًا، وجّه المهام بحسب صعوبتها: أسند المهام البسيطة إلى Gemini 3.8 Flash، الذي لا يتجاوز سعره ثلث سعر Argon تقريبًا، واترك Argon للمهام الطويلة والمعقدة.
نصيحة: يمكنك البدء بالحصول على رصيد تجريبي من APIYI على apiyi.com، ثم تشغيل سكربت التوجيه أعلاه على حركة الاستخدام الفعلية لمدة أسبوع، وتعديل عتبات التوجيه وحدود الإخراج وفقًا لسجلات الاستخدام.
الأسئلة الشائعة
س1: هل سعر Gemini 4 Argon الحالي هو $2/$10 أم $4/$20؟
أعلنت Google رسميًا عن سعر تجريبي قدره $2/$10، وسعر رسمي قدره $4/$20، لكنها لم تحدد مدة الفترة التجريبية أو ما إذا كانت جميع قنوات الوصول تطبّق السعر التجريبي نفسه. وتشير معلومات متداولة في المجتمع إلى أن Vertex AI يعرض السعر الرسمي $4/$20. يُنصح بالاعتماد على سعر الوحدة الظاهر في فاتورة قناة الوصول التي تستخدمها، وإعداد ميزانيتك وفقًا للسعرين.
س2: هل يمكن استخدام gemini-4-argon-cyber-permissive مباشرةً على Vertex AI؟
يبدو من اسمه أن هذا الإصدار موجّه لفرق الدفاع السيبراني، مع تخفيف ضوابط الأمن السيبراني، وأن الوصول إليه مرتبط ببرنامج Fairwind. عادةً لا تملك المشاريع العادية صلاحية استدعائه. على العملاء العاديين الذين يدفعون مقابل الخدمة الاعتماد على معرّف النموذج الظاهر في Model Garden ضمن وحدة التحكم الخاصة بهم. وإذا كنت لا ترغب في إعداد مشاريع GCP والحصص والأذونات، فيمكنك أيضًا استدعاء نماذج Gemini المختلفة عبر منصات تجميع مثل APIYI apiyi.com.
س3: هل تُفرض رسوم إضافية على رموز التفكير في Argon؟
لم توضح Google ذلك بصورة منفصلة حتى الآن، لكن رموز التفكير في نماذج Gemini الحالية تُحاسَب وفق سعر الإخراج؛ لذا يُنصح باعتماد القاعدة نفسها عند إعداد الميزانية. وبما أن Argon يستهلك عددًا أكبر من رموز الإخراج في المتوسط، فغالبًا ما تكون رموز التفكير مصدرًا رئيسيًا للتكلفة. ويمكن ضبط التكلفة من خلال تحديد max_tokens وتعديل مستوى الاستدلال.
س4: ما المهام التي تستحق استخدام Gemini 4 Argon المدفوع؟
تبرز مزايا Argon في المهام الطويلة والمعقدة، مثل ترحيل كميات كبيرة من الشيفرات، وتحليل المستندات الطويلة والمتخصصة، ووكلاء الذكاء الاصطناعي في المجالين القانوني والمالي، وتدقيق الأمان. أما الأسئلة اليومية، وإكمال الشيفرات البسيطة، والمهام الخفيفة ذات معدل الطلبات المرتفع، فعادةً ما تكون النماذج الأقل سعرًا مثل Gemini 3.8 Flash خيارًا أوفر. وأفضل طريقة لاتخاذ القرار هي إجراء مقارنة A/B باستخدام مهام حقيقية على منصة APIYI apiyi.com، ثم تحديد نسبة توجيه الطلبات لكل نموذج.
الخلاصة
يمكن تلخيص تسعير Gemini 4 Argon بأنه «سعر معلن جذاب، لكن تحيط به متغيرات كثيرة». فالسعر التجريبي البالغ $2/$10 تنافسي جدًا بين النماذج الرائدة، وخصم التخزين المؤقت البالغ 95% ملائم خصوصًا لسيناريوهات الوكلاء. لكن ارتفاع استهلاك رموز الاستدلال، ومضاعفة سعر الوحدة بعد انتهاء الفترة التجريبية، واحتمال تطبيق Vertex AI للسعر الرسمي مباشرةً، كلها عوامل قد تجعل الفاتورة الفعلية مختلفة بوضوح عن التوقعات المبنية على السعر المعلن.
وبما أن Gemini 4 Argon أصبح متاحًا الآن عبر Vertex AI، فالأولوية ليست التحول الكامل إليه فورًا، بل قياس توزيع استهلاك الرموز باستخدام حركة مرور حقيقية، ثم ضبط التكلفة من خلال تحديد الحد الأقصى للإخراج، واستخدام بادئات التخزين المؤقت، وتوجيه المهام بحسب مستوى صعوبتها. ونوصي بالتعامل مع Argon على أنه نموذج رائد «للمهام الصعبة»، واستخدامه إلى جانب نماذج من فئة Flash.
نوصي بالوصول إلى نماذج Gemini المختلفة عبر منصة APIYI، لمقارنة تكلفة Argon وأدائه مع النماذج الأخرى من خلال الواجهة نفسها، واتخاذ قرارات استراتيجية بشأن النماذج بناءً على البيانات لا الأسعار المعلنة.
المراجع:
- مقالة Google الرسمية عن إطلاق Gemini 4 Argon: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- صفحة Google التعريفية ببرنامج Fairwind: deepmind.google/fairwind-program
- مراجعة DataCamp لمعايير أداء Gemini 4 Argon وأسعاره: datacamp.com/blog/gemini-4-argon
- بيانات Artificial Analysis عن تكلفة النماذج ومؤشر الذكاء: artificialanalysis.ai
- تقييمات Vals AI للنماذج وبيانات تكلفتها: vals.ai
الكاتب: فريق APIYI | نتابع باستمرار أسعار نماذج اللغة الكبيرة وتطورات إتاحتها. لمزيد من أخبار إتاحة نماذج الذكاء الاصطناعي، تفضل بزيارة APIYI apiyi.com