Gemini 4 Argon trouxe novidades: depois do anúncio oficial em 30 de setembro e da liberação inicial para os defensores de redes do programa Fairwind, o Gemini 4 Argon já está disponível para seleção no Vertex AI. A expansão oficial no Google Cloud começou. Para a maioria dos desenvolvedores, a questão mais prática agora é: quanto custa o Gemini 4 Argon e quanto será preciso pagar por mês depois de integrá-lo?
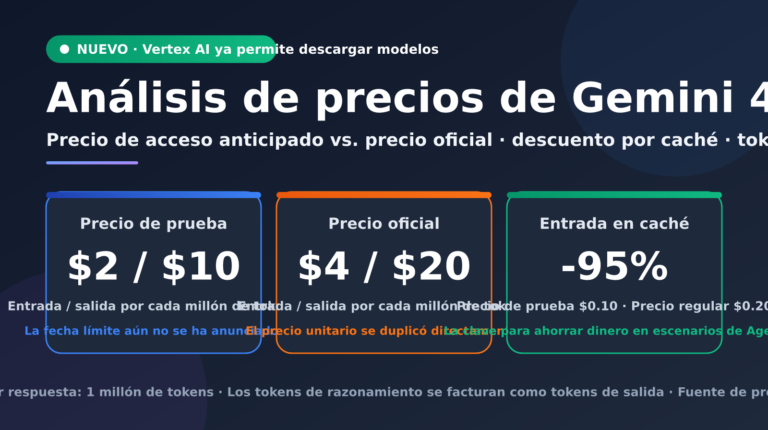
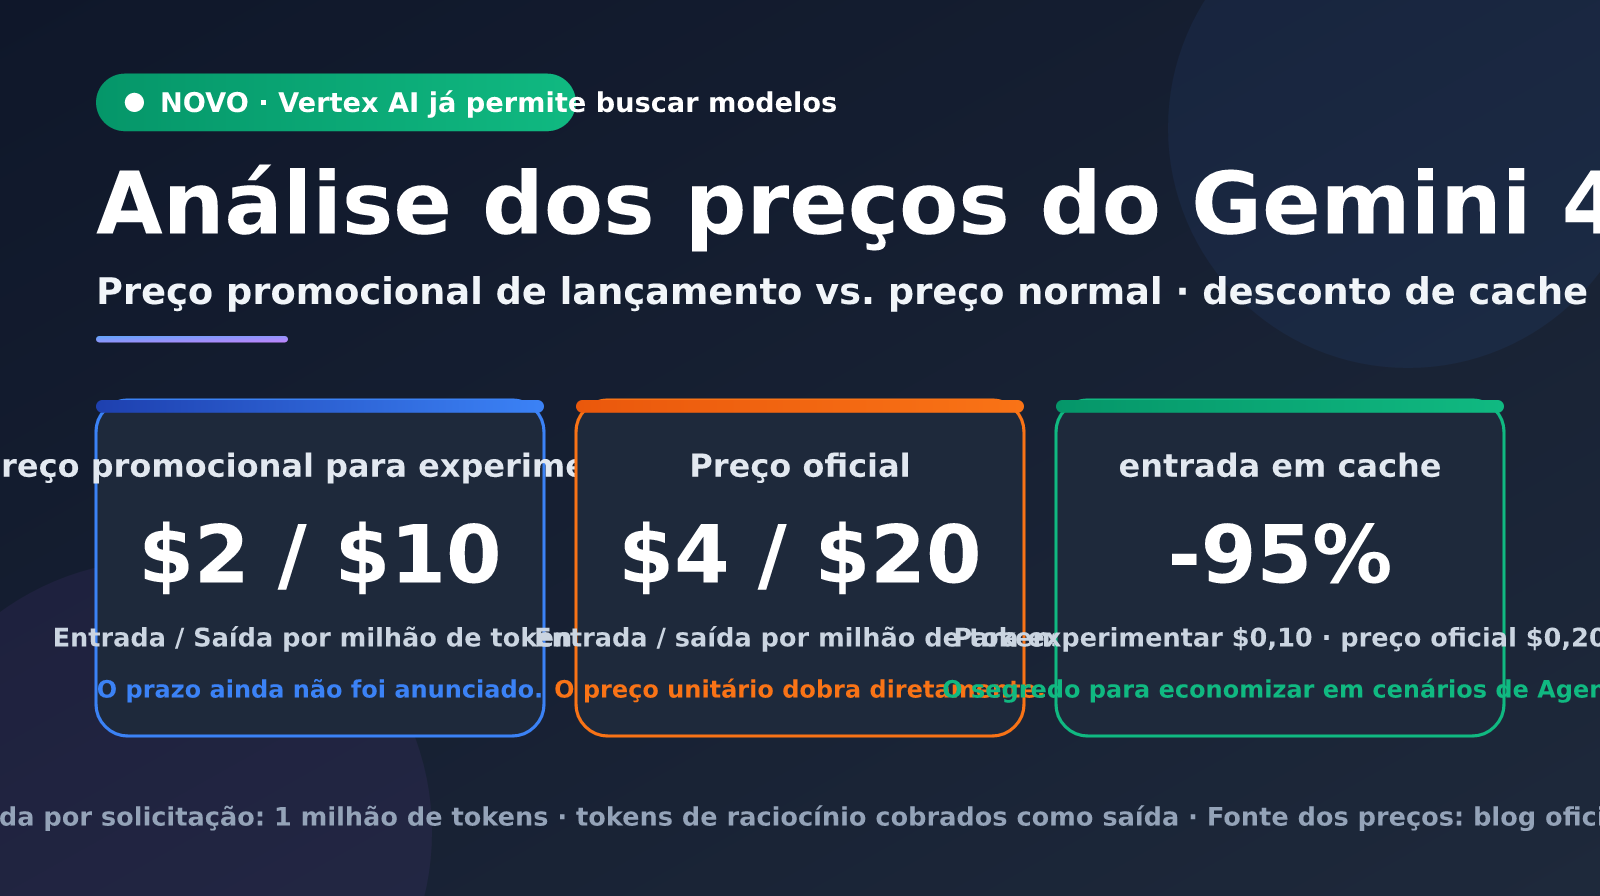
À primeira vista, o preço do Argon é simples: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída durante o período de acesso antecipado; depois, os valores dobram para US$ 4/US$ 20. Já os tokens de entrada em cache têm 95% de desconto. Mas essa tabela esconde algumas variáveis: como os tokens de raciocínio são cobrados, se o limite de 1 milhão de tokens de saída pode fazer o custo de uma única solicitação sair do controle e quanto maior é o consumo de tokens do Argon em comparação com o dos concorrentes. Neste artigo, analisamos os preços do Gemini 4 Argon item por item, com base em publicações oficiais do Google, veículos de imprensa internacionais e dados públicos de avaliações independentes. Também calculamos os custos para cinco cenários típicos.
O que você vai encontrar: ao terminar a leitura, você poderá calcular o custo real de cada tarefa do Gemini 4 Argon no seu negócio, entender como a fatura muda depois do período de acesso antecipado e descobrir como reduzir os custos com cache e limites de saída.
Preços do Gemini 4 Argon em resumo
Vamos começar organizando em uma tabela os preços divulgados oficialmente pelo Google. Vale destacar que a empresa informou apenas duas faixas: o preço de acesso antecipado e o preço padrão. Não especificou por quanto tempo durará o período de acesso antecipado nem divulgou detalhes sobre Batch, Flex, faixas de contexto longo ou tarifas de armazenamento em cache.
| Item de cobrança | Acesso antecipado (por milhão de tokens) | Preço padrão (por milhão de tokens) | Observações |
|---|---|---|---|
| Entrada | US$ 2,00 | US$ 4,00 | Duração do período de acesso antecipado não divulgada |
| Saída | US$ 10,00 | US$ 20,00 | O método de cobrança dos tokens de raciocínio não foi especificado separadamente |
| Tokens de entrada em cache | US$ 0,10 | US$ 0,20 | Desconto de 95% sobre o preço de entrada; o valor do preço padrão foi calculado aplicando o mesmo desconto |
| Limite de saída por solicitação | 1 milhão de tokens | 1 milhão de tokens | Os modelos Gemini anteriores tinham limite de 64 mil |
| Batch / Flex | Não divulgado | Não divulgado | Os modelos Gemini atuais geralmente oferecem descontos para processamento em lote |
| Faixas de contexto longo | Não divulgado | Não divulgado | O Google também não divulgou a janela de contexto de entrada |
Três detalhes importantes sobre os preços do Gemini 4 Argon
O primeiro detalhe são os tokens de raciocínio. O Google não explicou separadamente como os tokens de pensamento do Argon serão cobrados. No entanto, a prática atual da família Gemini é cobrar esses tokens pela tarifa de saída. Para fazer um orçamento com mais segurança, o melhor é presumir que o Argon seguirá a mesma regra: todo o processo de raciocínio será contabilizado a US$ 10 (acesso antecipado) ou US$ 20 (preço padrão) por milhão de tokens.
O segundo detalhe é o desconto do cache. Um desconto de 95% significa que, durante o período de acesso antecipado, os tokens de entrada em cache custam apenas US$ 0,10 por milhão. Em fluxos de trabalho com agentes, o comando do sistema, as definições das ferramentas e o contexto do código costumam ser reenviados a cada rodada da conversa. A taxa de acerto do cache frequentemente passa de 70%, então esse desconto pode ter um impacto maior na fatura total do que o preço anunciado de US$ 2.
O terceiro detalhe é a incerteza sobre o período de acesso antecipado. Quando ele terminar, todos os preços unitários dobrarão, mas o Google não informou a data de encerramento. Por isso, se você calcular o ROI com base nos preços de acesso antecipado, também vale preparar uma estimativa usando os preços padrão. Assim, você evita ser pego de surpresa caso a fatura dobre de repente.
🎯 Dica para o orçamento: há várias variáveis nos preços do Gemini 4 Argon. O ideal é começar com um volume pequeno e medir o consumo real de tokens antes de decidir por uma migração em larga escala. Com a plataforma APIYI apiyi.com, você pode invocar diferentes famílias de modelos — como Gemini, GPT e Claude — usando uma interface unificada, o que facilita comparar os custos reais com o mesmo conjunto de tarefas.
Últimas novidades sobre a chegada do Gemini 4 Argon ao Vertex AI
O cronograma de disponibilização do Argon é uma das principais dúvidas dos desenvolvedores. De acordo com o plano publicado no blog do Google, o Argon seria oferecido primeiro aos participantes do programa Fairwind — defensores de redes de confiança — e às equipes internas do Google. Depois, chegaria aos clientes de API pagos e aos assinantes do Google AI Ultra. Só então seria disponibilizado a um público mais amplo de desenvolvedores, empresas e consumidores. A tabela abaixo resume o caminho entre o anúncio e a disponibilidade do modelo no Vertex AI.
| Data | Evento | Fonte |
|---|---|---|
| 3 de setembro | Lançamento do programa Fairwind, com o Gemini 3.8 Flash Cyber como modelo inicial | Blog oficial do Google |
| 30 de setembro | Anúncio do Gemini 4 Argon, disponibilizado aos participantes do Fairwind | Blog oficial do Google |
| 30 de setembro | Verificação do DataCamp: modelo ainda não disponível no Vertex AI, Gemini CLI e outras plataformas | DataCamp |
| 7 e 8 de outubro | Comunidade encontra a entrada gemini-4-argon-cyber-permissive no Vertex AI |
Comunidade e mídia de tecnologia |
| Meados de outubro | O modelo Gemini 4 Argon já pode ser acessado no Vertex AI | Atualização mais recente |
O ID gemini-4-argon-cyber-permissive, encontrado primeiro pela comunidade, é interessante. “Cyber-permissive” sugere uma versão voltada à defesa cibernética, com restrições de segurança cibernética mais flexíveis — o que combina com a descrição do blog do Google de uma versão “sem barreiras de segurança cibernética” para defensores de confiança. É provável que a versão destinada a clientes pagos em geral use outro ID e mantenha todas as proteções de segurança. Por isso, ao fazer a integração, confira o ID do modelo exibido no Model Garden do seu próprio console do Google Cloud, em vez de copiar diretamente os nomes que circulam na internet.
Preços do Gemini 4 Argon no Vertex AI e mudanças na plataforma
Segundo informações da comunidade, o preço global do Argon exibido no Vertex AI é de US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída — ou seja, corresponde à faixa de preço oficial mencionada no blog do Google. Isso merece atenção: se o uso pelo Vertex AI for cobrado diretamente pelo preço oficial, todas as estimativas feitas com base no preço promocional de US$ 2/US$ 10 terão de ser dobradas. O Google ainda não esclareceu quais canais se qualificam para o preço promocional. Antes de integrar o modelo, confira o preço unitário efetivamente exibido na página de faturamento do console.
Outra mudança fácil de passar despercebida diz respeito à própria plataforma. No evento Cloud Next, em abril de 2026, o Google integrou os serviços do Vertex AI à Gemini Enterprise Agent Platform, e a documentação antiga do Vertex AI já informa que não será mais atualizada. Os endpoints existentes continuam funcionando, mas a documentação e os novos recursos de modelos como o Argon devem aparecer primeiro na Agent Platform. Além disso, Gemini 2.5 Pro, 2.5 Flash e 2.5 Flash-Lite serão descontinuados em 16 de outubro. Para as equipes que ainda usam esses modelos, esta pode ser uma boa oportunidade para concluir a migração de uma só vez.
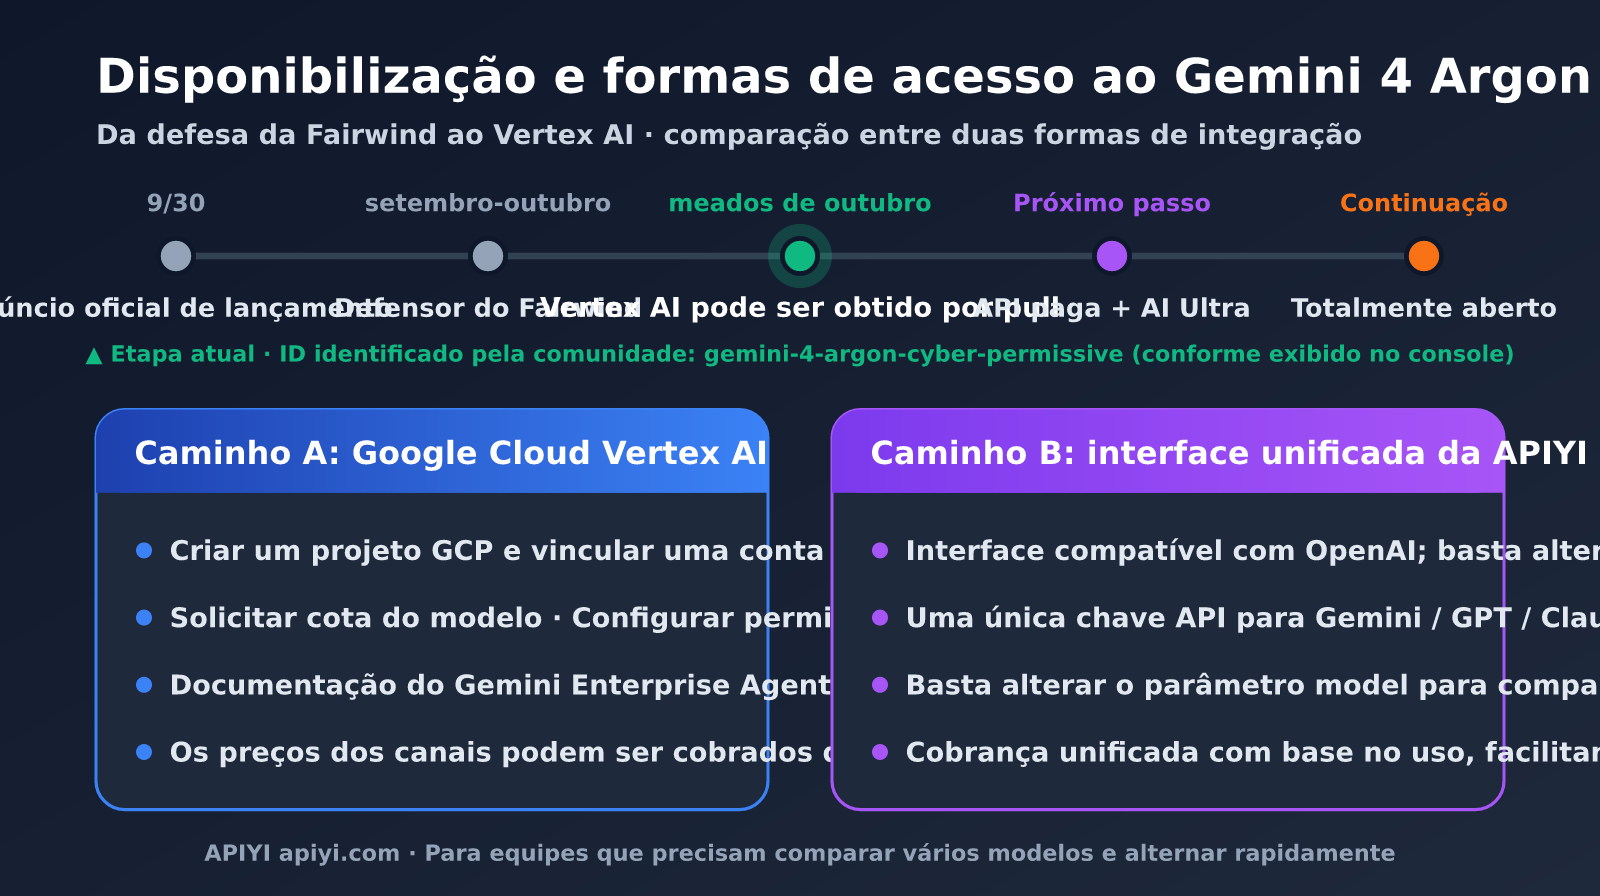
🚀 Sugestão de integração: usar o Vertex AI diretamente exige um projeto do GCP, uma conta de faturamento, solicitação de cotas e configuração do IAM — uma barreira considerável para equipes pequenas e médias. Recomendamos integrar os modelos Gemini por meio da API compatível com OpenAI da plataforma APIYI apiyi.com. Basta alterar o parâmetro
modelpara alternar entre o Argon e outros modelos.
Comparação de preços do Gemini 4 Argon: modelos da mesma família e concorrentes
É difícil saber se o Argon é caro olhando apenas o preço por token. Para ter uma visão mais clara, vale compará-lo com o Gemini 3.8 Flash, da mesma família, e com os principais modelos concorrentes. A tabela abaixo mostra os preços publicados. Os valores dos concorrentes foram compilados por terceiros; consulte as páginas oficiais de cada fornecedor para confirmar os preços.
| Modelo | Entrada / milhão de tokens | Saída / milhão de tokens | Limite de saída por chamada | Posicionamento |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | — | Uso diário, ótimo custo-benefício |
| Gemini 4 Argon (preço promocional) | $2.00 | $10.00 | 1M | Modelo de ponta para raciocínio em múltiplas etapas |
| Gemini 4 Argon (preço regular) | $4.00 | $20.00 | 1M | Modelo de ponta para raciocínio em múltiplas etapas |
| Claude Opus 5.5 | $4.00 | $20.00 | 128K | Modelo concorrente de ponta |
| GPT-6 Astra | $10.00 | $50.00 | 128K | Modelo concorrente de ponta |
Pelo preço por token, o preço promocional do Argon é cerca de 2,7 vezes o do Gemini 3.8 Flash. Já o preço regular fica no mesmo patamar do Claude Opus 5.5 e equivale a apenas 40% do preço do GPT-6 Astra. Mas o preço por token é só metade da história: a outra metade é quantos tokens são necessários para concluir a mesma tarefa. É aí que está o principal ponto de atenção na precificação do Argon.
Custo do Gemini 4 Argon por tarefa: o consumo de tokens é o que importa
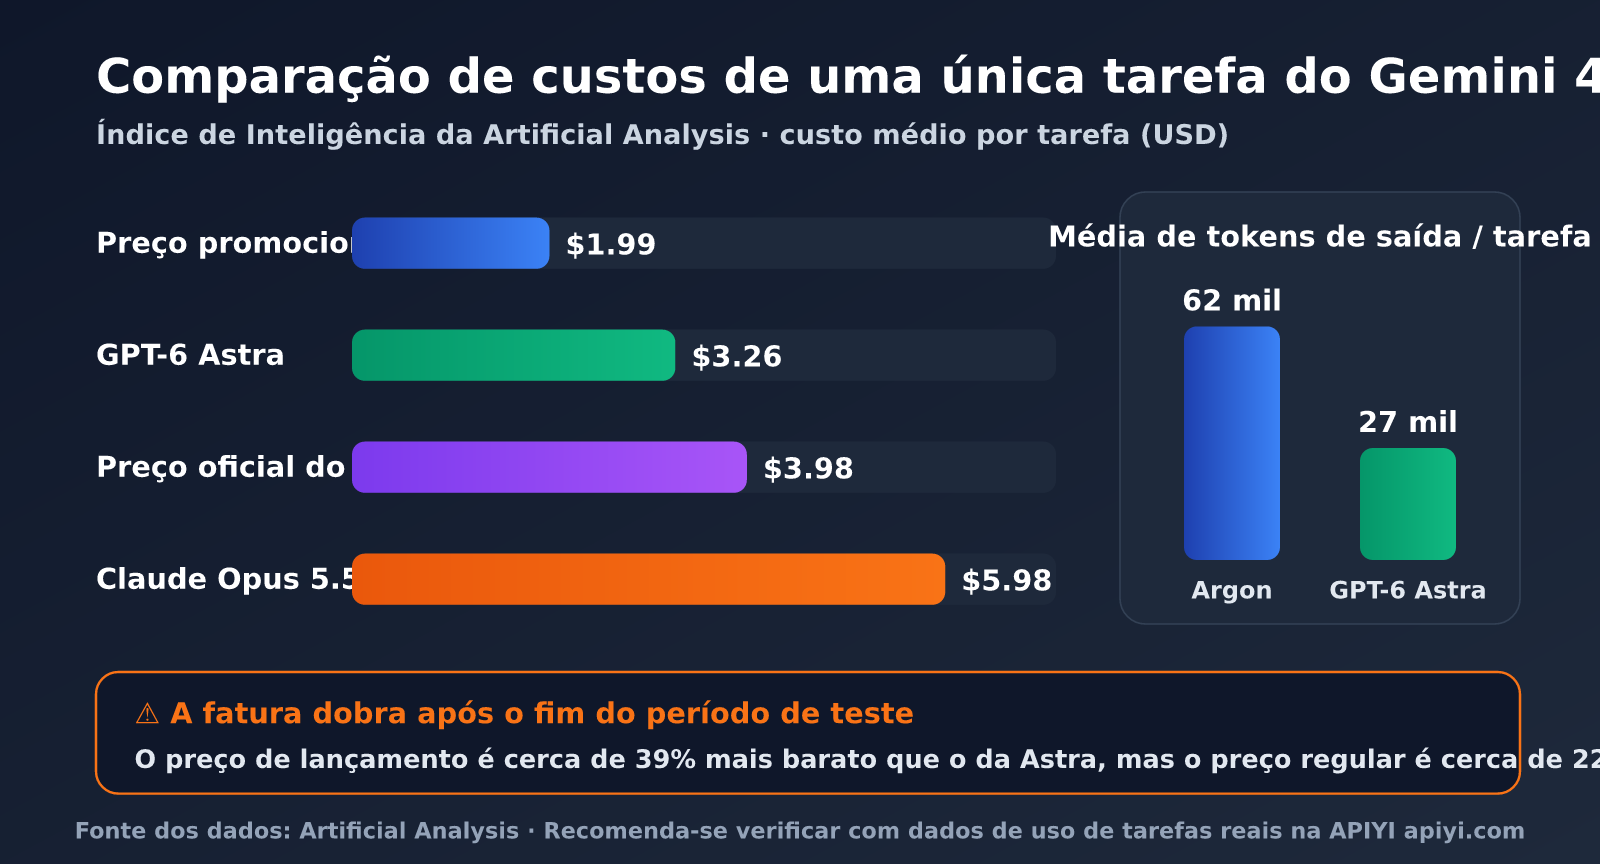
Os custos por tarefa publicados por instituições independentes de avaliação ajudam a entender melhor a situação do que o preço por token. Segundo dados da Artificial Analysis, o Argon gera, em média, cerca de 62 mil tokens de saída por tarefa no teste de índice de inteligência. O GPT-6 Astra, que obteve a mesma pontuação, usou apenas cerca de 27 mil: ou seja, o Argon gera mais que o dobro de texto.
| Critério de avaliação | Gemini 4 Argon | Modelo de comparação | Conclusão |
|---|---|---|---|
| Custo por tarefa da AA (preço promocional) | $1.99 | GPT-6 Astra $3.26 | Durante a promoção, cerca de 39% mais barato que o Astra |
| Custo por tarefa da AA (preço regular) | $3.98 | GPT-6 Astra $3.26 | No preço regular, cerca de 22% mais caro que o Astra |
| Custo por tarefa da AA | $1.99 | Claude Opus 5.5 $5.98 | Cerca de um terço do custo do Opus 5.5 |
| Custo por teste da Vals | $15.68 | Opus 5.5 $32.14 / Sonnet 5.5 $21.34 | Menor custo nesse tipo de carga de trabalho |
| Média de tokens de saída por tarefa | Cerca de 62 mil | GPT-6 Astra: cerca de 27 mil | O processo de raciocínio do Argon é bem mais longo |
A tabela revela o ponto mais importante sobre o preço do Gemini 4 Argon: durante o período promocional, o custo-benefício é muito bom, mas, depois que a promoção acabar, ele poderá custar mais que o GPT-6 Astra, mesmo em algumas tarefas nas quais o preço por token do Astra é mais alto. Isso acontece por causa do maior consumo de tokens de saída. Por outro lado, o teste da Vals mostra que o Argon tem o menor custo em outro tipo de carga de trabalho. Ou seja, a conclusão depende bastante da tarefa: é essencial fazer as contas com os seus próprios dados.
💡 Dica para escolher: preço por token baixo não significa conta baixa. Na plataforma APIYI apiyi.com, teste o Argon e outros modelos de ponta com o mesmo conjunto de tarefas reais e registre o campo
usagede cada chamada. Use o consumo real de tokens — não o preço anunciado — para definir sua estratégia de roteamento.
Estimativa do custo real do Gemini 4 Argon: 5 cenários típicos
A seguir, usamos os preços publicados pelo Google para estimar o custo de uma chamada em 5 cenários típicos, considerando tanto o preço promocional quanto o regular. Os tokens de raciocínio são contabilizados como tokens de saída.
| Cenário | Tokens de entrada | Tokens de saída | Custo promocional | Custo regular |
|---|---|---|---|---|
| Perguntas e respostas do dia a dia | 20 mil | 5 mil | $0.09 | $0.18 |
| Análise de documentos longos | 200 mil | 50 mil | $0.90 | $1.80 |
| Programação com agente (80% de acertos no cache) | 600 mil | 62 mil | $0.91 | $1.82 |
| Migração de grandes bases de código | 300 mil | 400 mil | $4.60 | $9.20 |
| Saída máxima de 1M | Desconsiderado | 1 milhão | $10.00 | $20.00 |
No cenário de programação com agente, por exemplo, dos 600 mil tokens de entrada, 480 mil são atendidos pelo cache e custam apenas $0.048, à tarifa de $0.10. Os 120 mil restantes custam $0.24, à tarifa de $2. Os 62 mil tokens de saída custam $0.62, à tarifa de $10, totalizando cerca de $0.91. Como dá para ver, quando o cache é bem aproveitado, os tokens de saída representam quase 70% do custo total. Controlar o tamanho da saída é mais importante do que reduzir a entrada.
Os cenários de migração de grandes bases de código e de saída máxima de 1M exigem mais atenção. O limite de saída de 1M é um dos principais atrativos do Argon, mas uma chamada que use todo esse limite custa $20 no preço regular. Se a configuração de timeout do cliente for inadequada e uma falha provocar uma nova tentativa automática, o custo pode dobrar. Para equipes que executam centenas de tarefas longas por dia, esse tipo de custo oculto pode facilmente sair do controle na fatura mensal.
Custos ocultos do Gemini 4 Argon
Com base nas estimativas acima, fique de olho nestes possíveis custos ocultos ao integrar o Argon:
- Aumento no consumo de tokens de raciocínio: em média, o Argon gera mais que o dobro de tokens de saída do GPT-6 Astra. Como o processo de raciocínio é cobrado pela tarifa de saída, ele pode elevar bastante o custo por tarefa.
- Saídas muito longas e novas tentativas: com um limite de saída de 1M, configurações inadequadas de timeout no cliente ou no balanceador de carga podem fazer chamadas longas falharem e serem repetidas, multiplicando os custos.
- Falhas de cache: uma estrutura de comando mal planejada pode reduzir bastante a taxa de acerto do cache, fazendo você perder o desconto de 95%.
- Fim do período promocional: todos os preços por token dobram, e não há uma data de término claramente definida.
- Diferenças de preço entre canais: o preço exibido no Vertex AI pode já ser o regular, uma diferença de até duas vezes em relação às estimativas feitas com o preço promocional.
Práticas para economizar ao integrar o Gemini 4 Argon
Para lidar com os custos ocultos mencionados acima, as três medidas mais eficazes são: definir um limite claro de saída para cada solicitação, colocar o conteúdo estável no início do comando para aumentar a taxa de acerto do cache e direcionar as tarefas para modelos diferentes conforme o nível de dificuldade. O exemplo abaixo usa uma interface compatível com a OpenAI, e o ID do modelo é configurado por variável de ambiente.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# 模型 ID 以平台或 Vertex AI 控制台实际显示为准
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")

resp = client.chat.completions.create(
    model=ARGON,
    max_tokens=16000,  # 显式设置输出上限,避免默认放开到 1M
    messages=[{"role": "user", "content": "分析这段代码的并发安全问题"}],
)
u = resp.usage
print(f"输入 {u.prompt_tokens} / 输出 {u.completion_tokens} token")
Ver o código completo: roteamento por dificuldade + registro de custos
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

# 模型与单价全部配置化,尝鲜期结束后只需改环境变量
ROUTES = {
    "easy": {
        "model": os.getenv("FLASH_MODEL", "gemini-3.8-flash"),
        "price_in": 0.75, "price_out": 3.75, "max_tokens": 8000,
    },
    "hard": {
        "model": os.getenv("ARGON_MODEL", "gemini-4-argon"),
        "price_in": float(os.getenv("ARGON_PRICE_IN", "2")),
        "price_out": float(os.getenv("ARGON_PRICE_OUT", "10")),
        "max_tokens": 64000,
    },
}

# 稳定前缀放在最前面,提升缓存命中率
SYSTEM_PREFIX = open("system_prompt.md", encoding="utf-8").read()


def classify(task: str) -> str:
    """简单示例:长任务、迁移、审计类任务走 Argon,其余走 Flash"""
    keywords = ("迁移", "重构", "审计", "漏洞", "多文件")
    return "hard" if len(task) > 4000 or any(k in task for k in keywords) else "easy"


def run(task: str) -> str:
    route = ROUTES[classify(task)]
    resp = client.chat.completions.create(
        model=route["model"],
        max_tokens=route["max_tokens"],
        messages=[
            {"role": "system", "content": SYSTEM_PREFIX},
            {"role": "user", "content": task},
        ],
        timeout=600,  # 长输出任务放宽超时,避免失败重试导致成本翻倍
    )
    u = resp.usage
    cost = (u.prompt_tokens * route["price_in"]
            + u.completion_tokens * route["price_out"]) / 1_000_000
    print(f"[{route['model']}] in={u.prompt_tokens} out={u.completion_tokens} "
          f"估算成本 ${cost:.4f}(未计缓存折扣)")
    return resp.choices[0].message.content


if __name__ == "__main__":
    print(run("把 legacy/ 目录下的 C 模块迁移为 Rust,并保持接口一致"))
Este código coloca em prática três princípios para economizar. Primeiro, defina max_tokens explicitamente em vez de depender do limite de saída enorme padrão do modelo. Segundo, coloque o comando do sistema como prefixo estável no início, para aumentar as chances de acerto do cache entre solicitações. Terceiro, direcione as tarefas conforme a dificuldade: deixe as tarefas simples para o Gemini 3.8 Flash, cujo preço unitário é cerca de um terço do Argon, e reserve o Argon para tarefas longas e complexas.
Dica: você pode obter créditos de teste na APIYI (apiyi.com) e executar o script de roteamento com tráfego real durante uma semana. Depois, ajuste os limites de roteamento e de saída com base nos registros de uso.
Perguntas frequentes
Q1: O preço atual do Gemini 4 Argon é US$ 2/US$ 10 ou US$ 4/US$ 20?
O preço promocional anunciado oficialmente pelo Google é de US$ 2/US$ 10, e o preço oficial é de US$ 4/US$ 20. No entanto, a empresa não informou por quanto tempo a oferta ficará disponível nem se todos os canais vão aplicar o mesmo preço promocional. Há relatos da comunidade de que o Vertex AI exibe o preço oficial de US$ 4/US$ 20. Confira o preço unitário cobrado pelo canal que você usa e faça o orçamento considerando os dois valores.
Q2: Posso usar diretamente o gemini-4-argon-cyber-permissive no Vertex AI?
Pelo nome, esse ID parece identificar uma versão voltada à defesa cibernética, com salvaguardas de segurança cibernética menos restritivas. Ela está associada ao acesso do programa Fairwind, e projetos comuns geralmente não têm permissão para invocá-la. Clientes pagantes devem usar o ID do modelo exibido no Model Garden do próprio console. Se preferir não lidar com configurações de projetos, cotas e permissões do GCP, também é possível acessar os modelos da família Gemini por plataformas agregadoras, como a APIYI (apiyi.com).
Q3: Os tokens de raciocínio do Argon têm cobrança adicional?
O Google ainda não deu detalhes específicos, mas, nos modelos Gemini atuais, os tokens de raciocínio são cobrados pelo preço de saída. Recomendamos fazer o orçamento seguindo essa mesma regra. Como o Argon tende a gerar mais tokens em média, os tokens de raciocínio podem representar uma parte significativa do custo. É possível controlar os gastos limitando max_tokens e ajustando a intensidade do raciocínio.
Q4: Em quais situações vale a pena pagar pelo Gemini 4 Argon?
Tarefas longas e complexas, como migrações de código em larga escala, análise especializada de documentos extensos, agentes de IA para as áreas jurídica e financeira e auditorias de segurança, são as que mais aproveitam as vantagens do Argon e justificam o custo. Para perguntas do dia a dia, conclusão simples de código e tarefas leves com alto volume de solicitações, modelos mais baratos, como o Gemini 3.8 Flash, costumam valer mais a pena. A opção mais segura é comparar o desempenho em tarefas reais com testes A/B na APIYI (apiyi.com) antes de decidir a proporção de roteamento.
Resumo
O preço do Gemini 4 Argon pode ser resumido assim: “preço de tabela atraente, mas com muitas variáveis”. A tarifa promocional de US$ 2/US$ 10 é bastante competitiva entre os modelos de ponta, e o desconto de 95% no cache é especialmente vantajoso para cenários com agentes. Porém, o alto consumo de tokens de raciocínio, a duplicação do preço por unidade após o fim do período promocional e a possibilidade de o canal do Vertex AI aplicar diretamente o preço padrão podem fazer com que a conta real fique bem diferente do esperado com base no preço de tabela.
Agora que o Gemini 4 Argon já está disponível no Vertex AI, o próximo passo não é migrar tudo de uma vez, mas medir a distribuição do consumo de tokens com tráfego real. Depois, dá para controlar os custos definindo limites de saída, usando prefixos em cache e direcionando as solicitações conforme o nível de dificuldade. Recomendamos posicionar o Argon como um modelo de ponta “para problemas difíceis” e combiná-lo com modelos da linha Flash.
Recomendamos usar a plataforma APIYI apiyi.com para integrar os modelos Gemini em um só lugar. Assim, você pode comparar custos e resultados do Argon com os de outros modelos pela mesma interface e definir sua estratégia com base em dados, não apenas no preço de tabela.
Referências:
- Anúncio oficial do Gemini 4 Argon no blog do Google: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Página de apresentação do programa Fairwind do Google: deepmind.google/fairwind-program
- Compilação de benchmarks e preços do Gemini 4 Argon pela DataCamp: datacamp.com/blog/gemini-4-argon
- Custos dos modelos e índice de inteligência da Artificial Analysis: artificialanalysis.ai
- Avaliações de modelos e dados de custos da Vals AI: vals.ai
Autor: APIYI Team | Acompanhamos continuamente os preços dos Modelos de Linguagem Grande e as novidades de integração. Para saber mais sobre a integração de modelos de IA, acesse APIYI apiyi.com.