Gemini 4 Argon에 새로운 진전이 있어요. 9월 30일 공식 발표 후 Fairwind 프로그램에 참여하는 네트워크 방어 담당자에게 먼저 공개된 데 이어, 이제 Vertex AI에서 Gemini 4 Argon 모델을 사용할 수 있게 됐어요. Google Cloud에서도 본격적으로 공급을 확대하기 시작한 거예요. 대부분의 개발자에게 이제 가장 현실적인 질문은 하나예요. Gemini 4 Argon의 요금은 어떻게 책정되고, 도입하면 매달 비용이 얼마나 들까요?
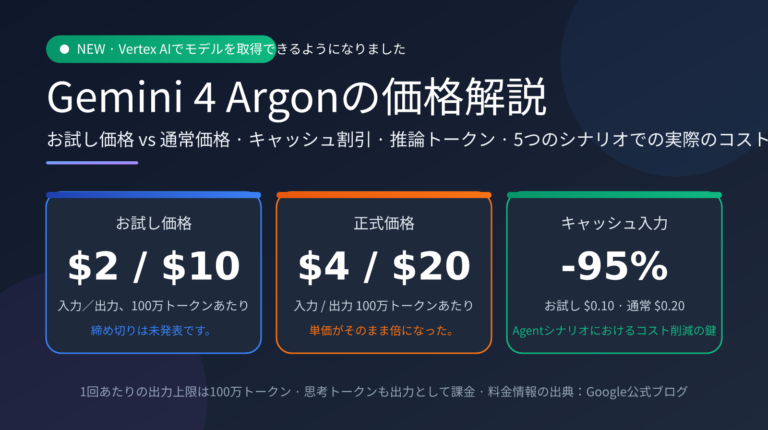
겉으로 보기에는 Argon의 가격이 간단해 보여요. 체험 가격은 입력 100만 토큰당 $2, 출력 100만 토큰당 $10이고, 정식 가격은 각각 $4와 $20예요. 캐시 입력에는 95% 할인이 적용돼요. 하지만 가격표 뒤에는 몇 가지 변수가 숨어 있어요. 추론 토큰은 어떻게 과금되는지, 출력 한도가 100만 토큰이면 요청 한 번의 비용이 감당하기 어려울 정도로 커질 수 있는지, Argon의 토큰 소비량은 경쟁 모델보다 얼마나 많은지 살펴봐야 해요. 이 글에서는 Google 공식 블로그와 여러 영어 매체, 제3자 평가 기관이 공개한 데이터를 바탕으로 Gemini 4 Argon의 가격을 항목별로 분석하고, 대표적인 5가지 시나리오의 비용도 계산해 볼게요.
핵심 가치: 이 글을 읽으면 실제 비즈니스에서 Gemini 4 Argon을 작업 하나에 사용할 때 드는 비용을 계산하고, 체험 기간이 끝난 뒤 청구 금액이 어떻게 달라지는지 파악할 수 있어요. 캐시와 출력 한도를 활용해 비용을 줄이는 방법도 확인할 수 있습니다.
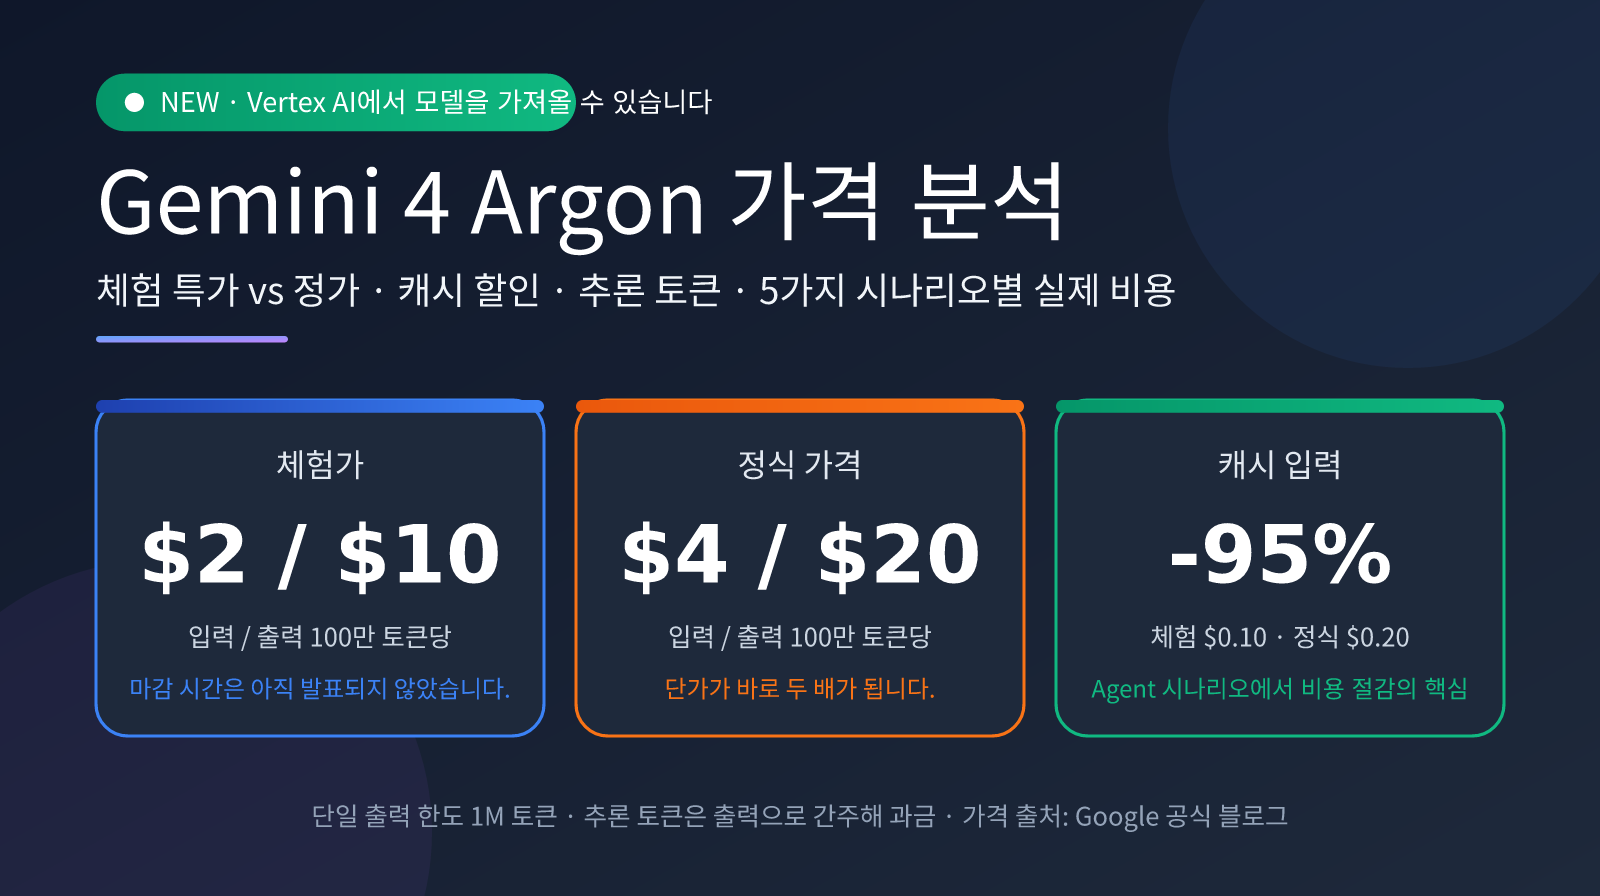
Gemini 4 Argon 가격 한눈에 보기
먼저 Google이 공식 발표한 가격 정보를 표로 정리해 볼게요. Google은 체험 가격과 정식 가격, 두 가지 요금만 공개했어요. 체험 기간이 얼마나 이어지는지는 밝히지 않았고, Batch·Flex 요금, 긴 컨텍스트 구간별 요금, 캐시 저장 비용 등도 공개하지 않았습니다.
| 과금 항목 | 체험 가격(100만 토큰당) | 정식 가격(100만 토큰당) | 설명 |
|---|---|---|---|
| 입력 | $2.00 | $4.00 | 체험 기간 미공개 |
| 출력 | $10.00 | $20.00 | 추론 토큰의 과금 방식은 별도로 안내되지 않음 |
| 캐시 입력 | $0.10 | $0.20 | 입력 가격에서 95% 할인. 정식 가격도 동일한 할인율을 적용해 계산 |
| 요청당 출력 한도 | 100만 토큰 | 100만 토큰 | 기존 Gemini 모델은 64K |
| Batch / Flex | 미공개 | 미공개 | 기존 Gemini 모델은 보통 Batch 할인 제공 |
| 긴 컨텍스트 구간별 요금 | 미공개 | 미공개 | 입력 컨텍스트 윈도우도 공식 미공개 |
Gemini 4 Argon 가격의 핵심 세부 사항 3가지
첫 번째는 추론 토큰이에요. Google은 Argon의 사고 토큰이 어떻게 과금되는지 별도로 안내하지 않았어요. 다만 현재 Gemini 제품군에서는 사고 토큰을 출력 가격으로 과금하는 것이 일반적이에요. 예산을 세울 때는 Argon도 같은 규칙을 따른다고 가정하는 편이 가장 안전해요. 즉, 모든 추론 과정이 100만 토큰당 체험 가격 $10 또는 정식 가격 $20으로 청구된다고 보면 됩니다.
두 번째는 캐시 할인입니다. 캐시 입력에 95% 할인이 적용되면 체험 기간에는 100만 토큰당 $0.10만 내면 돼요. 에이전트 워크플로에서는 매 대화마다 시스템 프롬프트, 도구 정의, 코드베이스 컨텍스트를 반복해서 보내야 하는 경우가 많아요. 캐시 적중률이 70%를 넘는 경우도 흔한 만큼, 이 할인은 입력 가격 $2보다 전체 청구 금액에 더 큰 영향을 미칠 수 있어요.
세 번째는 체험 기간의 불확실성이에요. 체험 기간이 끝나면 모든 단가가 두 배로 오르지만, Google은 종료 시점을 공개하지 않았어요. 따라서 체험 가격을 기준으로 ROI를 계산하더라도 정식 가격을 적용한 계산도 함께 준비하는 게 좋아요. 어느 날 갑자기 청구 금액이 두 배가 되는 상황에 대비할 수 있습니다.
🎯 예산 설정 팁: Gemini 4 Argon은 가격에 영향을 미치는 변수가 많아요. 먼저 적은 트래픽으로 운영해 실제 토큰 소비 분포를 확인한 뒤, 대규모 전환 여부를 결정하는 것이 좋습니다. APIYI apiyi.com 플랫폼에서는 하나의 통합 인터페이스로 Gemini, GPT, Claude 등 여러 모델 제품군을 호출할 수 있어 동일한 작업으로 실제 비용을 비교하기 편리해요.
Gemini 4 Argon의 Vertex AI 출시 최신 동향
Argon의 공개 일정은 개발자들이 가장 궁금해하는 사안이에요. Google 블로그에 공개된 계획에 따르면, Argon은 먼저 Fairwind 프로그램의 신뢰할 수 있는 네트워크 방어 담당자와 Google 내부에 제공된 뒤 유료 API 고객과 Google AI Ultra 구독자에게 공개되고, 마지막으로 더 많은 개발자와 기업, 일반 사용자에게 제공될 예정이에요. 아래 표에서 공식 발표부터 Vertex AI에서 사용할 수 있게 되기까지의 일정을 확인해 보세요.
| 시기 | 이벤트 | 출처 |
|---|---|---|
| 9월 3일 | Fairwind 프로그램 시작, 첫 모델로 Gemini 3.8 Flash Cyber 공개 | Google 공식 블로그 |
| 9월 30일 | Gemini 4 Argon 공식 발표, Fairwind 회원에게 배포 | Google 공식 블로그 |
| 9월 30일 | DataCamp 확인 결과: Vertex AI, Gemini CLI 등에 미등록 | DataCamp |
| 10월 7~8일 | 커뮤니티에서 Vertex AI의 gemini-4-argon-cyber-permissive 항목 발견 |
커뮤니티 및 기술 매체 |
| 10월 중순 | Vertex AI에서 Gemini 4 Argon 모델 사용 가능 | 최신 동향 |
커뮤니티에서 가장 먼저 발견한 gemini-4-argon-cyber-permissive라는 ID는 꽤 흥미로워요. “cyber-permissive”라는 표현은 네트워크 방어 담당자를 위해 사이버 보안 가드레일을 완화한 버전이라는 뜻으로 보입니다. 이는 Google 블로그에서 “신뢰할 수 있는 방어 담당자에게는 사이버 보안 가드레일을 적용하지 않는다”고 설명한 내용과도 일치해요. 일반 유료 고객용 버전은 다른 ID를 사용하고, 보안 기능도 온전히 유지할 가능성이 높습니다. 따라서 연동할 때는 온라인에 떠도는 이름을 그대로 사용하지 말고, Google Cloud 콘솔의 Model Garden에 실제로 표시되는 모델 ID를 기준으로 삼으세요.
Vertex AI의 Gemini 4 Argon 가격 및 플랫폼 변화
커뮤니티에 따르면 Vertex AI에 표시된 Argon의 글로벌 가격은 입력 100만 토큰당 4달러, 출력 100만 토큰당 20달러로, Google 블로그에 공개된 정식 가격과 같아요. 눈여겨볼 부분입니다. 기업이 Vertex AI를 통해 연동할 때 정식 가격이 바로 적용된다면, 2달러/10달러의 출시 특가를 기준으로 한 비용 추산은 모두 두 배로 늘어나게 됩니다. 출시 특가가 어떤 채널에 적용되는지는 Google이 아직 명확히 밝히지 않았으니, 연동 전에 콘솔의 결제 페이지에 표시된 실제 단가를 확인하세요.
간과하기 쉬운 또 다른 변화는 플랫폼 자체예요. Google은 2026년 4월 Cloud Next 행사에서 Vertex AI 서비스를 Gemini Enterprise Agent Platform에 통합했고, 기존 Vertex AI 문서에는 더 이상 업데이트되지 않는다고 안내했어요. 기존 엔드포인트는 계속 사용할 수 있지만, Argon과 같은 신규 모델의 문서와 새 기능은 Agent Platform에 우선 제공될 예정입니다. 또한 Gemini 2.5 Pro, 2.5 Flash, 2.5 Flash-Lite는 10월 16일에 서비스가 종료됩니다. 이 모델을 사용 중인 팀이라면 이번 기회에 마이그레이션을 한 번에 진행해 보세요.
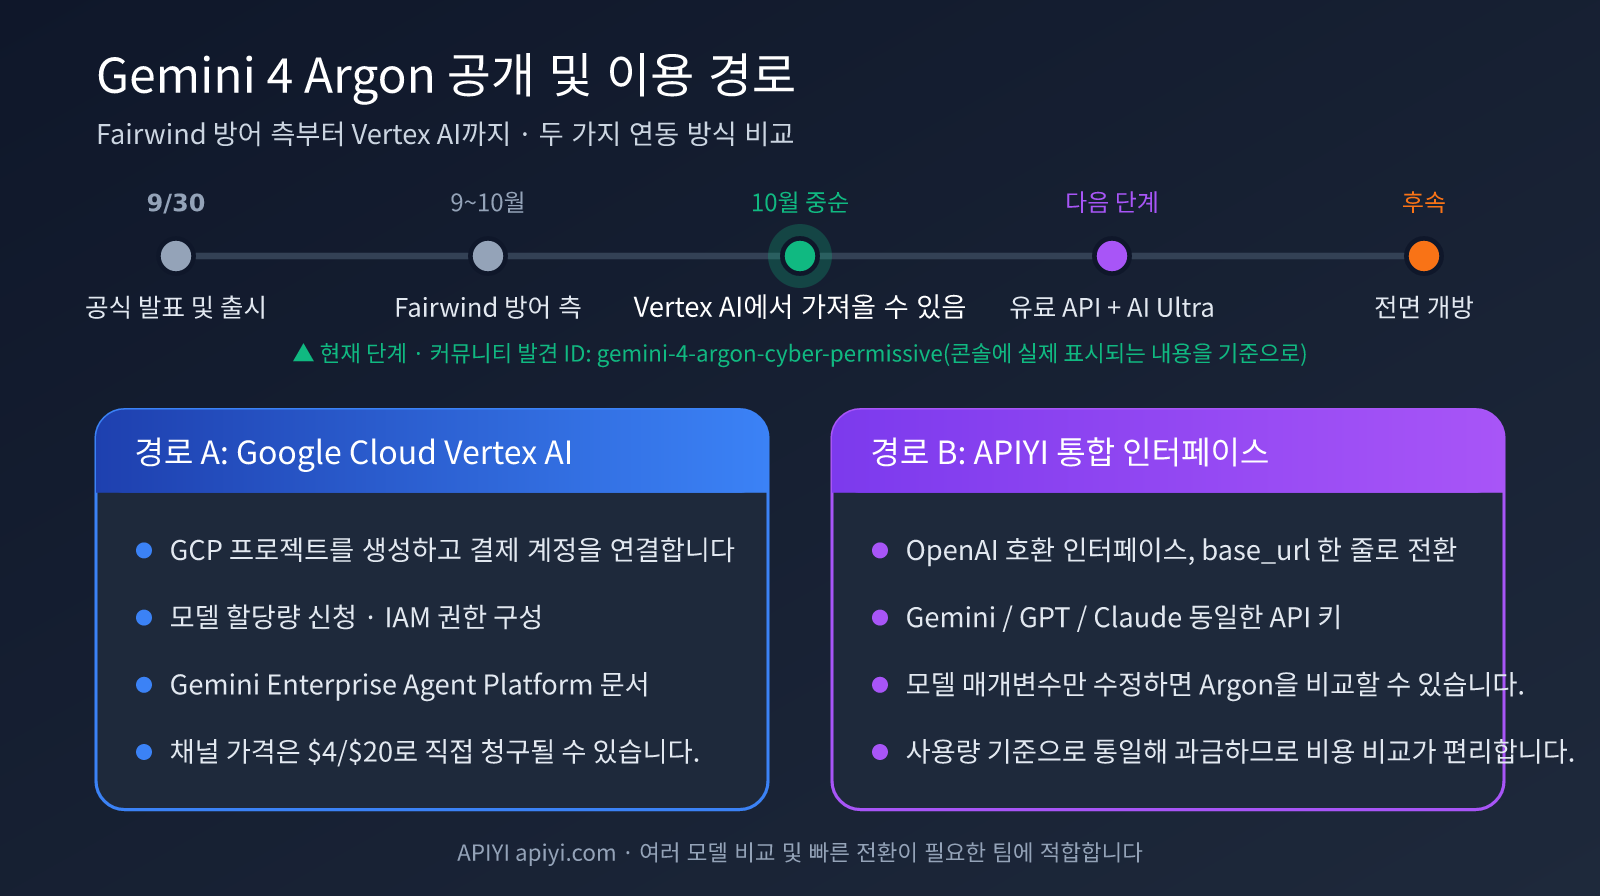
🚀 연동 제안: Vertex AI를 직접 사용하려면 GCP 프로젝트와 결제 계정, 할당량 신청, IAM 설정이 필요해 중소 규모 팀에는 진입 장벽이 높아요. APIYI apiyi.com 플랫폼의 OpenAI 호환 인터페이스로 Gemini 계열 모델을 통합해 사용해 보세요.
model매개변수만 바꾸면 Argon과 다른 모델 사이를 전환할 수 있어요.
Gemini 4 Argon 가격 비교: 같은 라인업 및 경쟁 모델
단가만 봐서는 Argon이 비싼지 판단하기 어려워요. 같은 라인업의 Gemini 3.8 Flash와 경쟁사 플래그십 모델을 함께 비교해 봐야 합니다. 아래 표는 각 모델의 표시 가격이며, 경쟁 모델 가격은 제3자가 정리한 자료를 참고했습니다. 정확한 가격은 각 업체의 공식 페이지에서 확인하세요.
| 모델 | 입력 / 백만 토큰 | 출력 / 백만 토큰 | 단일 출력 한도 | 포지션 |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 일상적인 주력 모델, 높은 가성비 |
| Gemini 4 Argon(얼리 액세스 가격) | $2.00 | $10.00 | 1M | 긴 추론 작업을 위한 플래그십 |
| Gemini 4 Argon(정식 가격) | $4.00 | $20.00 | 1M | 긴 추론 작업을 위한 플래그십 |
| Claude Opus 5.5 | $4.00 | $20.00 | 128K | 경쟁사 플래그십 |
| GPT-6 Astra | $10.00 | $50.00 | 128K | 경쟁사 플래그십 |
단가를 기준으로 보면 Argon의 얼리 액세스 가격은 Gemini 3.8 Flash의 약 2.7배예요. 정식 가격은 Claude Opus 5.5와 같고, GPT-6 Astra의 40% 수준입니다. 하지만 단가는 비용의 절반일 뿐이에요. 나머지 절반은 같은 작업을 완료하는 데 토큰을 얼마나 쓰느냐입니다. Argon의 가격을 평가할 때 특히 주의해야 할 부분이죠.
Gemini 4 Argon의 작업당 비용: 핵심은 토큰 사용량
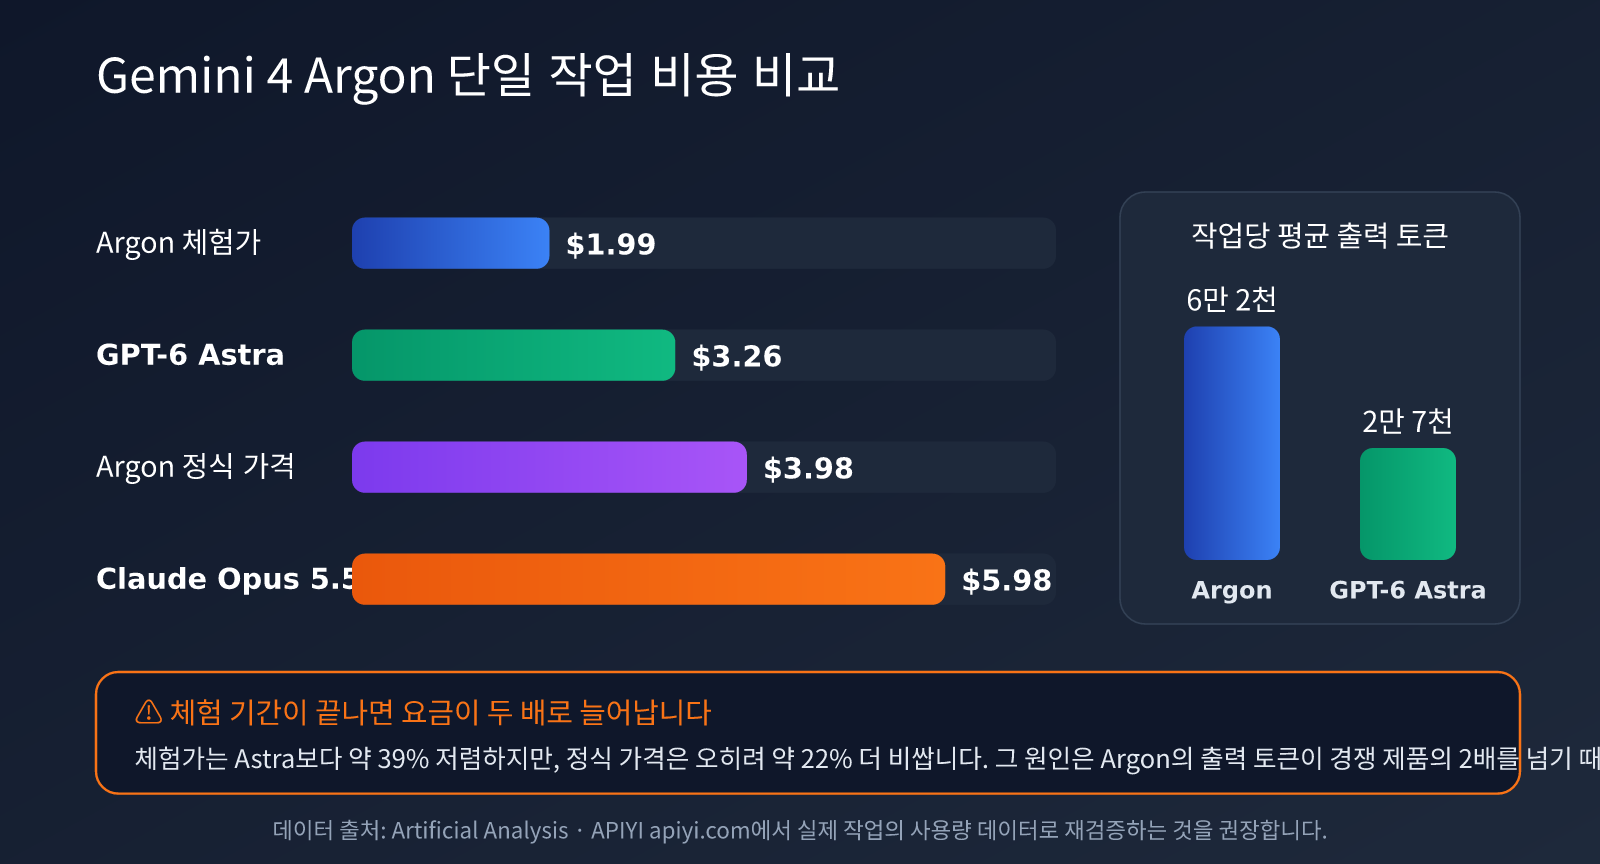
제3자 평가 기관이 측정한 작업당 비용을 보면 단가보다 더 정확하게 비교할 수 있어요. Artificial Analysis의 데이터에 따르면, Argon은 지능 지수 테스트에서 작업당 평균 약 6.2만 개의 출력 토큰을 생성했습니다. 같은 점수를 얻은 GPT-6 Astra는 약 2.7만 개만 사용했어요. Argon의 출력량이 경쟁 모델보다 2배 이상 많은 셈입니다.
| 평가 기준 | Gemini 4 Argon | 비교 모델 | 결론 |
|---|---|---|---|
| AA 작업당 비용(얼리 액세스 가격) | $1.99 | GPT-6 Astra $3.26 | 얼리 액세스 기간에는 Astra보다 약 39% 저렴 |
| AA 작업당 비용(정식 가격) | $3.98 | GPT-6 Astra $3.26 | 정식 가격에서는 오히려 Astra보다 약 22% 비쌈 |
| AA 작업당 비용 | $1.99 | Claude Opus 5.5 $5.98 | Opus 5.5의 약 3분의 1 |
| Vals 테스트 1회 비용 | $15.68 | Opus 5.5 $32.14 / Sonnet 5.5 $21.34 | 해당 워크로드에서 가장 저렴 |
| 작업당 평균 출력 토큰 | 약 6.2만 | GPT-6 Astra 약 2.7만 | Argon의 추론 과정이 훨씬 김 |
이 표에서 알 수 있는 Gemini 4 Argon 가격의 핵심은 다음과 같아요. 얼리 액세스 기간에는 Argon의 가성비가 높지만, 기간이 끝난 뒤에는 일부 워크로드에서 단가가 더 높은 GPT-6 Astra보다도 비용이 많이 들 수 있습니다. 출력 토큰 사용량이 많기 때문이에요. 다만 Vals 테스트에서는 Argon의 비용이 가장 낮게 나왔습니다. 어떤 작업을 하느냐에 따라 결과가 크게 달라지므로, 실제 데이터를 바탕으로 비용을 계산해 봐야 해요.
💡 모델 선택 팁: 단가가 낮다고 해서 청구 금액도 적은 건 아니에요. APIYI apiyi.com 플랫폼에서 동일한 실제 작업을 Argon과 다른 플래그십 모델에 각각 요청해 보세요. 각 요청의 usage 필드를 기록하고, 표시 가격이 아니라 실제 토큰 사용량을 기준으로 라우팅 전략을 세우는 것이 좋습니다.
Gemini 4 Argon 실제 비용 계산: 대표적인 5가지 시나리오
Google이 공개한 단가를 기준으로, 얼리 액세스 가격과 정식 가격을 적용해 대표적인 5가지 시나리오의 요청 1회 비용을 계산해 볼게요. 사고 토큰은 모두 출력 토큰에 포함해 계산했습니다.
| 시나리오 | 입력 토큰 | 출력 토큰 | 얼리 액세스 가격 기준 비용 | 정식 가격 기준 비용 |
|---|---|---|---|---|
| 일상적인 질의응답 | 2만 | 5000 | $0.09 | $0.18 |
| 긴 문서 분석 | 20만 | 5만 | $0.90 | $1.80 |
| 에이전트 코딩(캐시 적중률 80%) | 60만 | 6.2만 | $0.91 | $1.82 |
| 대규모 코드 마이그레이션 | 30만 | 40만 | $4.60 | $9.20 |
| 출력 1M 한도까지 사용 | 무시할 수 있는 수준 | 100만 | $10.00 | $20.00 |
에이전트 코딩 시나리오를 예로 들어 볼게요. 입력 60만 토큰 중 48만 토큰이 캐시에 적중하면, $0.10 요금이 적용돼 비용은 $0.048입니다. 나머지 12만 토큰에는 $2 요금이 적용돼 $0.24가 들어요. 출력 6.2만 토큰은 $10 요금 기준으로 $0.62입니다. 모두 합하면 약 $0.91이죠. 캐시를 충분히 활용하면 출력 토큰이 전체 비용의 거의 70%를 차지합니다. 입력 비용을 줄이는 것보다 출력 길이를 제어하는 일이 더 중요해요.
대규모 코드 마이그레이션과 출력 1M 한도까지 사용하는 시나리오는 특히 주의해야 해요. 출력 1M 한도는 Argon의 핵심 장점이지만, 정식 가격에서는 한 번의 요청으로 한도를 모두 사용하면 $20가 청구됩니다. 클라이언트의 타임아웃을 잘못 설정해 요청이 실패한 뒤 자동으로 재시도되면 비용이 바로 두 배가 될 수 있어요. 매일 긴 작업을 수백 번 처리하는 팀이라면 이런 숨은 비용 때문에 월 청구액이 쉽게 감당하기 어려운 수준으로 늘어날 수 있습니다.
Gemini 4 Argon 숨은 비용 체크리스트
위의 계산을 바탕으로, Argon을 도입할 때 다음과 같은 숨은 비용에 특히 주의하세요.
- 추론 토큰 증가: Argon의 평균 출력 토큰은 GPT-6 Astra의 2배 이상입니다. 출력 요금이 적용되는 사고 과정 때문에 작업당 비용이 크게 늘어날 수 있어요.
- 긴 출력과 재시도: 출력 한도가 1M인 만큼, 클라이언트나 로드 밸런서의 타임아웃 설정이 적절하지 않으면 긴 요청이 실패하고 재시도될 수 있어요. 비용이 배로 늘어날 수 있습니다.
- 캐시 미적중: 프롬프트 구조가 적절하지 않으면 캐시 적중률이 매우 낮아져 95% 할인 혜택을 놓칠 수 있어요.
- 얼리 액세스 기간 종료: 모든 단가가 두 배로 올라가며, 종료 날짜도 명확하게 공개되지 않았어요.
- 공급 채널별 가격 차이: Vertex AI에 표시되는 가격은 정식 가격일 수 있어, 얼리 액세스 가격을 기준으로 계산한 금액과 두 배 차이가 날 수 있습니다.
Gemini 4 Argon 비용 절감형 연동 방법
앞서 살펴본 숨은 비용을 줄이는 가장 효과적인 방법은 세 가지예요. 요청마다 명확한 출력 한도를 설정하고, 캐시 적중률을 높이도록 고정된 내용을 프롬프트 앞부분에 배치하며, 작업 난이도에 따라 모델을 라우팅하는 거예요. 아래 예시는 OpenAI 호환 인터페이스를 사용하며, 모델 ID는 환경 변수로 설정합니다.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# 模型 ID 以平台或 Vertex AI 控制台实际显示为准
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")

resp = client.chat.completions.create(
    model=ARGON,
    max_tokens=16000,  # 显式设置输出上限,避免默认放开到 1M
    messages=[{"role": "user", "content": "分析这段代码的并发安全问题"}],
)
u = resp.usage
print(f"输入 {u.prompt_tokens} / 输出 {u.completion_tokens} token")
전체 코드 보기: 난이도별 라우팅 + 비용 기록
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

# 模型与单价全部配置化,尝鲜期结束后只需改环境变量
ROUTES = {
    "easy": {
        "model": os.getenv("FLASH_MODEL", "gemini-3.8-flash"),
        "price_in": 0.75, "price_out": 3.75, "max_tokens": 8000,
    },
    "hard": {
        "model": os.getenv("ARGON_MODEL", "gemini-4-argon"),
        "price_in": float(os.getenv("ARGON_PRICE_IN", "2")),
        "price_out": float(os.getenv("ARGON_PRICE_OUT", "10")),
        "max_tokens": 64000,
    },
}

# 稳定前缀放在最前面,提升缓存命中率
SYSTEM_PREFIX = open("system_prompt.md", encoding="utf-8").read()


def classify(task: str) -> str:
    """简单示例:长任务、迁移、审计类任务走 Argon,其余走 Flash"""
    keywords = ("迁移", "重构", "审计", "漏洞", "多文件")
    return "hard" if len(task) > 4000 or any(k in task for k in keywords) else "easy"


def run(task: str) -> str:
    route = ROUTES[classify(task)]
    resp = client.chat.completions.create(
        model=route["model"],
        max_tokens=route["max_tokens"],
        messages=[
            {"role": "system", "content": SYSTEM_PREFIX},
            {"role": "user", "content": task},
        ],
        timeout=600,  # 长输出任务放宽超时,避免失败重试导致成本翻倍
    )
    u = resp.usage
    cost = (u.prompt_tokens * route["price_in"]
            + u.completion_tokens * route["price_out"]) / 1_000_000
    print(f"[{route['model']}] in={u.prompt_tokens} out={u.completion_tokens} "
          f"估算成本 ${cost:.4f}(未计缓存折扣)")
    return resp.choices[0].message.content


if __name__ == "__main__":
    print(run("把 legacy/ 目录下的 C 模块迁移为 Rust,并保持接口一致"))
이 코드는 비용 절감 원칙 세 가지를 보여줘요. 첫째, 모델의 기본 출력 한도가 지나치게 클 수 있으므로 max_tokens를 명시적으로 설정하세요. 둘째, 여러 차례 요청할 때 캐시 적중률을 높일 수 있도록 시스템 프롬프트를 고정된 접두부로 맨 앞에 배치하세요. 셋째, 난이도에 따라 라우팅해 간단한 작업은 Argon보다 단가가 약 3분의 1인 Gemini 3.8 Flash에 맡기고, 긴 추론 과정이 필요하거나 난도가 높은 작업만 Argon에 맡기세요.
권장 사항: APIYI apiyi.com에서 테스트 크레딧을 받아 라우팅 스크립트로 실제 트래픽을 일주일간 처리해 보세요. 그런 다음 usage 로그를 바탕으로 라우팅 임계값과 출력 한도를 조정하면 됩니다.
자주 묻는 질문
Q1: 현재 Gemini 4 Argon 가격은 $2/$10인가요, $4/$20인가요?
Google이 공식적으로 공개한 체험 가격은 $2/$10이고 정식 가격은 $4/$20이에요. 하지만 체험 기간이 얼마나 지속되는지, 채널마다 체험 가격이 동일하게 적용되는지는 밝히지 않았어요. Vertex AI에는 정식 가격인 $4/$20이 표시된다는 커뮤니티 소식도 있습니다. 실제로 연동한 채널의 청구 단가를 기준으로 삼고, 두 가격대 모두 고려해 예산을 책정하는 것이 좋습니다.
Q2: Vertex AI에서 gemini-4-argon-cyber-permissive를 바로 사용할 수 있나요?
이 ID는 이름에서 알 수 있듯 네트워크 방어 담당자를 위한 모델로, 사이버 보안 가드레일을 완화한 버전이에요. Fairwind 프로그램 접근 권한이 필요한 모델이라 일반 프로젝트에는 호출 권한이 없는 경우가 많습니다. 일반 유료 고객은 본인의 콘솔 Model Garden에 표시된 모델 ID를 확인해야 해요. GCP 프로젝트, 할당량, 권한을 직접 설정하고 싶지 않다면 APIYI apiyi.com 같은 통합 플랫폼을 통해 Gemini 시리즈 모델을 한곳에서 호출할 수도 있습니다.
Q3: Argon의 사고 토큰에는 추가 요금이 부과되나요?
Google은 아직 별도로 안내하지 않았어요. 다만 기존 Gemini 모델의 사고 토큰은 출력 단가로 과금되므로 같은 기준으로 예산을 책정하는 것이 좋습니다. Argon은 평균 출력 토큰이 많은 편이라 사고 토큰이 비용의 주요 원인이 될 수 있어요. max_tokens를 제한하고 추론 강도를 조정해 비용을 관리할 수 있습니다.
Q4: 어떤 작업에 Gemini 4 Argon을 사용하는 것이 좋을까요?
대규모 코드 마이그레이션, 긴 전문 문서 분석, 법률·금융 분야 에이전트, 보안 감사처럼 추론 과정이 긴 작업에서 Argon의 강점이 가장 잘 드러나요. 이런 작업에는 비용을 지불할 만합니다. 일상적인 질의응답, 간단한 코드 완성, 높은 동시성이 필요한 가벼운 작업에는 Gemini 3.8 Flash 같은 저가 모델이 대체로 더 경제적이에요. 가장 확실한 방법은 APIYI apiyi.com 플랫폼에서 실제 작업으로 A/B 테스트를 진행한 뒤 라우팅 비율을 정하는 거예요.
요약
Gemini 4 Argon의 가격은 ‘표시 가격은 합리적이지만 변수가 많다’고 요약할 수 있어요. 체험 가격인 $2/$10은 플래그십 모델 중에서도 경쟁력 있고, 95% 캐시 할인은 특히 Agent 시나리오에 유리해요. 하지만 추론 토큰 사용량이 많고, 체험 기간이 끝나면 단가가 두 배로 오르며, Vertex AI에서는 정식 가격이 바로 적용될 수 있어요. 이 세 가지 요인 때문에 실제 청구 금액이 표시 가격으로 예상한 금액과 크게 달라질 수 있습니다.
Gemini 4 Argon을 Vertex AI에서 사용할 수 있게 된 지금, 중요한 건 서둘러 전면 전환하는 게 아니에요. 실제 트래픽으로 토큰 사용량 분포를 먼저 측정한 다음, 출력 상한과 캐시 프리픽스, 난이도별 라우팅을 적용해 비용을 관리해야 해요. Argon은 Flash급 모델과 함께 사용하면서 ‘어려운 문제 전용’ 플래그십 모델로 두는 것을 권장합니다.
APIYI apiyi.com 플랫폼을 통해 Gemini 시리즈 모델을 통합해 사용하는 것도 권장해요. 하나의 인터페이스에서 Argon과 다른 모델의 비용과 성능을 비교하고, 표시 가격이 아닌 데이터를 바탕으로 모델 전략을 결정할 수 있습니다.
참고 자료:
- Google 공식 블로그의 Gemini 4 Argon 출시 글: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Google Fairwind Program 소개 페이지: deepmind.google/fairwind-program
- DataCamp의 Gemini 4 Argon 벤치마크 및 가격 정리: datacamp.com/blog/gemini-4-argon
- Artificial Analysis의 모델 비용 및 지능 지수: artificialanalysis.ai
- Vals AI의 모델 평가 및 비용 데이터: vals.ai
작성자: APIYI 팀 | 대규모 언어 모델 가격과 연동 동향을 꾸준히 추적하고 있습니다. 더 많은 AI 모델 연동 소식은 APIYI apiyi.com에서 확인하세요.